Le benchmark 4,8x de Cognition prouve le débit, pas des agents moins chers
Le premier client de CoreWeave pour Vera Rubin a publié un benchmark de débit à 4,8x, mais aucun chiffre de coût — alors que CoreWeave a relevé de 35 % le prix de ses GPU depuis juillet. Le chiffre dont les porteurs du titre CRWV ont besoin, le coût par session Devin achevée, ne figure nulle part dans les communiqués.
 Vincent Jiang · 3 min read
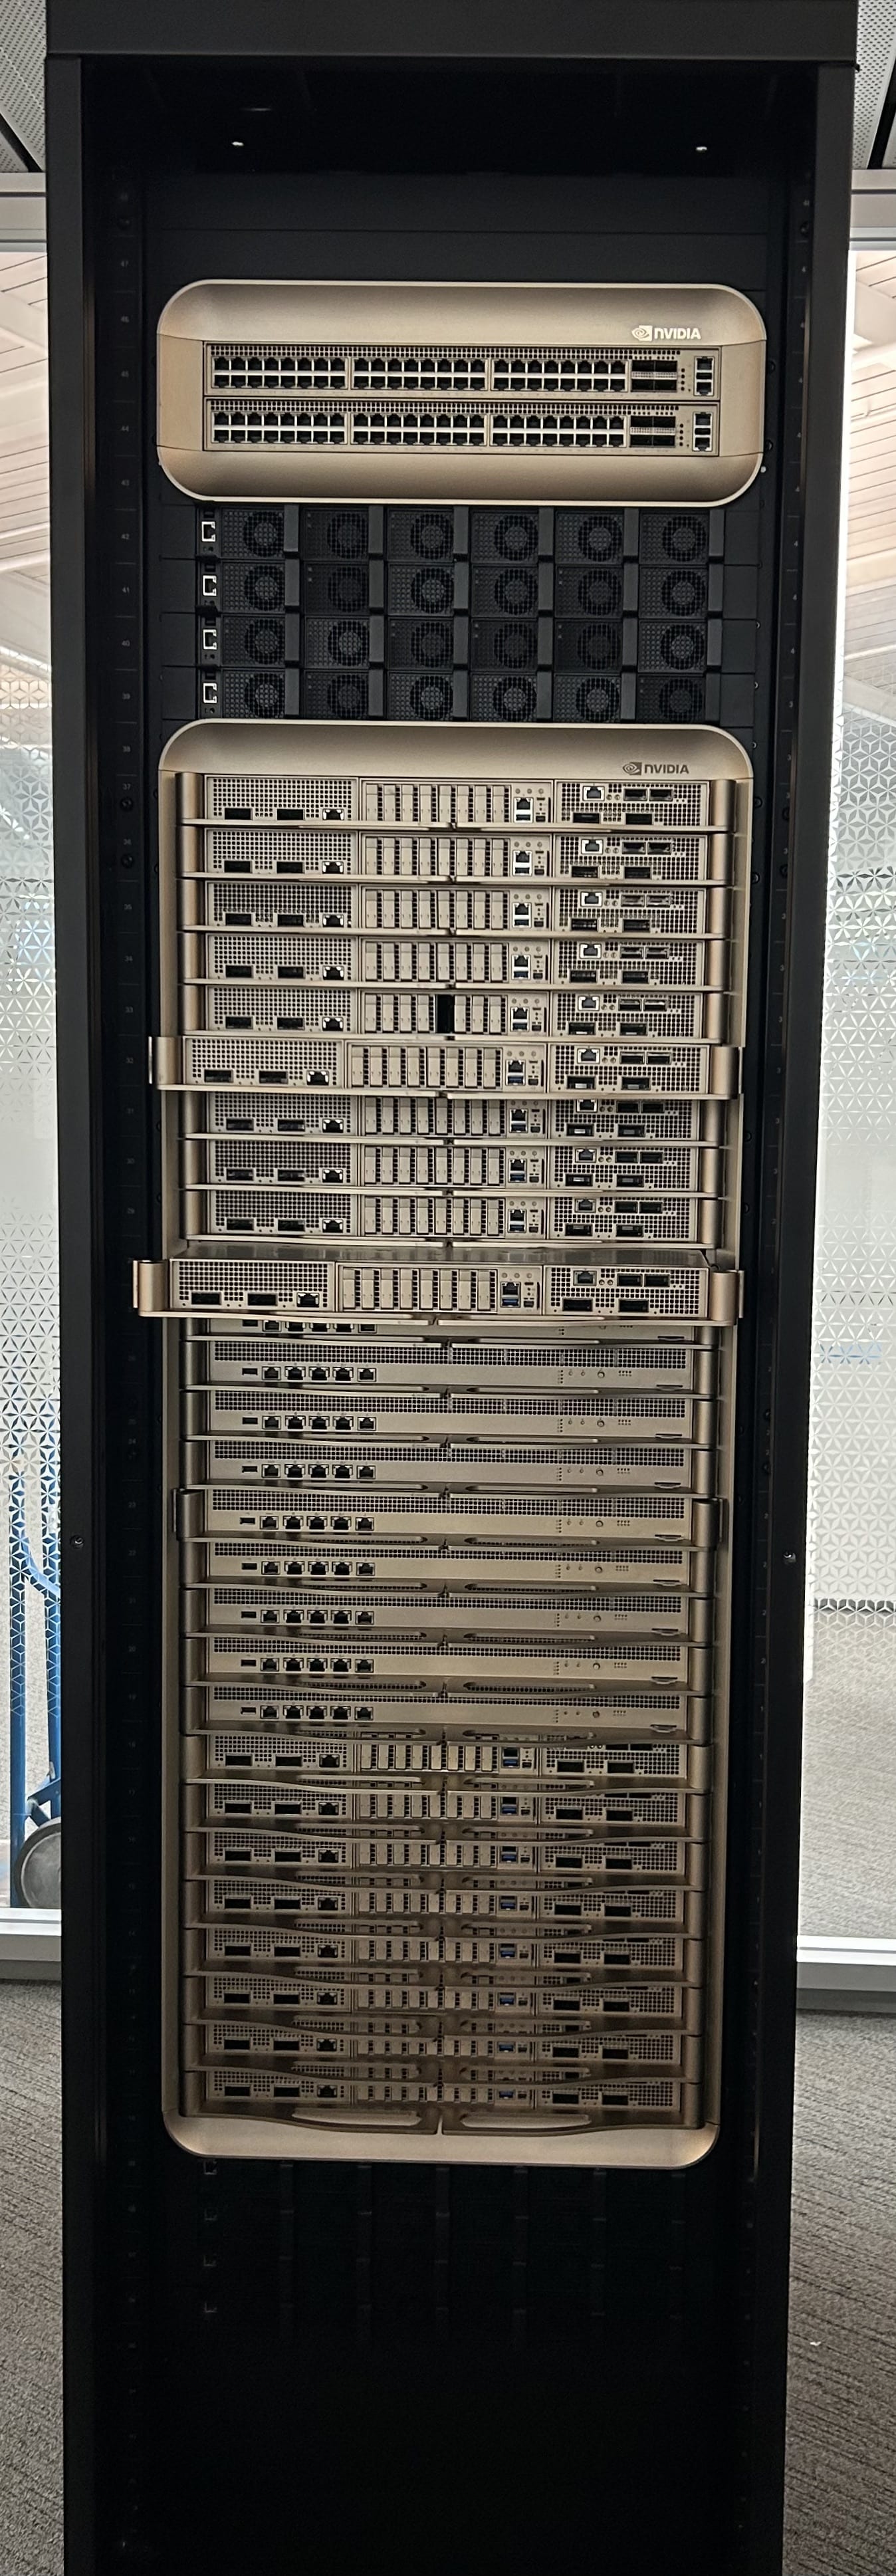
Cognition a l'habitude d'accompagner ses jalons de chiffres. Le 8 septembre, un tour de table en série E : plus de 2 milliards de dollars levés pour une valorisation de 48 milliards de dollars, avec un chiffre d'affaires annualisé — selon l'entreprise — passé de 492 millions de dollars en mai à près de 900 millions 1. Le 29 septembre, un partenariat avec MongoDB pour vendre Devin comme le moteur des migrations d'entreprise 2. Et le 30 septembre, à la conférence Fully Connected de CoreWeave, la société est devenue le premier client au monde à exécuter des charges de travail en production sur le Vera Rubin NVL72 de Nvidia, en annonçant un débit total de tokens jusqu'à 4,8 fois supérieur pour ses charges d'inférence SWE-2 face à une base GB200 NVL72, et un gain de 3,8 fois en apprentissage par renforcement 134.
Un benchmark sans facture
Les communiqués pêchent aux mêmes endroits. Aucun chiffre de débit absolu, aucun tarif, aucune donnée de consommation d'énergie, aucun détail de configuration suffisant pour reproduire la comparaison, aucun décompte des tâches achevées 1. Dans son communiqué, CoreWeave présente ces résultats comme des « benchmarks indépendants » ; ce sont pourtant les ingénieurs de Cognition eux-mêmes qui les ont menés, contre une base de référence hébergée sur le cloud de CoreWeave lui-même 4. La seule traduction en dollars est verbale : Chen Goldberg, qui dirige le produit et l'ingénierie chez CoreWeave, a expliqué que ces gains se traduisent par davantage de sessions Devin simultanées par GPU et par un « coût par session plus faible », et aucun communiqué n'a publié ce coût 34.
Deux gains annoncés, une base de référence, aucun coût nulle part
Data
| Débit de tokens, en multiples de la base de référence GB200 | |
|---|---|
| Base de référence GB200 | 1x |
| Inférence SWE-2 sur Vera Rubin (Cognition) | 4.8x |
| Tokens générés en apprentissage par renforcement sur Vera Rubin (Cognition) | 3.8x |
Le livre de comptes le plus lourd est celui de CoreWeave
Les enjeux se lisent sur deux livres de comptes. Cognition doit démontrer que les 2 milliards de dollars levés lui achètent une capacité de calcul capable de réduire le coût des longues exécutions de ses agents, alors même qu'elle fixe le prix de Devin face à Claude Code et Cursor 1. Le livre de comptes de CoreWeave est plus lourd : le groupe assure compter une demande dix fois supérieure pour chaque mégawatt de capacité et s'en tient à son objectif de déploiement de 8 GW d'ici à 2030 ; après la conférence, Cantor Fitzgerald a maintenu sa recommandation « surpondération » et son objectif de cours de 176 dollars sur le titre 5. Or cette montée en puissance est financée sur la foi de preuves de demande dont la première donnée publique n'est autre qu'un benchmark coécrit par le client et le fournisseur. Ce sont les porteurs de CRWV qui en assument le risque.
Le coût d'une session, le chiffre introuvable
Le débit n'est pas un argument économique. Si une session de Devin consomme davantage de tokens, un gain de 4,8x en tokens par seconde se traduit, en coût par tâche achevée, par un avantage bien moins spectaculaire. Et CoreWeave a relevé ses prix de 25 % depuis juillet, auxquels s'ajoutent encore 10 %, selon la note de Cantor Fitzgerald 5. L'argument silicium de CoreWeave elle-même — un débit de tokens par mégawatt multiplié par dix par rapport au GB200, mesuré sur DeepSeek R1 —, est un chiffre d'efficacité, pas une facture ; il figure dans le même communiqué, qui passe sous silence tout chiffre de coût 4. La veille, Cognition avait placé le même agent dans le pipeline de migrations de MongoDB, promettant que des travaux qui duraient cinq à six heures se bouclent désormais en un peu plus d'une heure 2. La vraie question de la semaine est de savoir si les baisses de prix à la tâche dans le codage par IA sont financées par l'efficacité ou par le capital. Tant qu'aucune des deux sociétés ne publie le coût par session sur Vera Rubin face au GB200, le marché valorise le multiple, pas le coût. Le débit n'est pas un argument économique.
Deepdive
AI-generated from this story and its cited sources. Not investment advice.