英伟达中国护城河所立足的软件层,DeepSeek刚刚免费开源了
包括对标CUDA的TileLang在内,六个面向昇腾芯片的开源软件模块,把中国的芯片软件攻坚从路线图推进到了代码仓库。对英伟达而言,重开中国市场的看多理由,如今只剩下北京放行这一条。
 Richard Tang · 3 min read
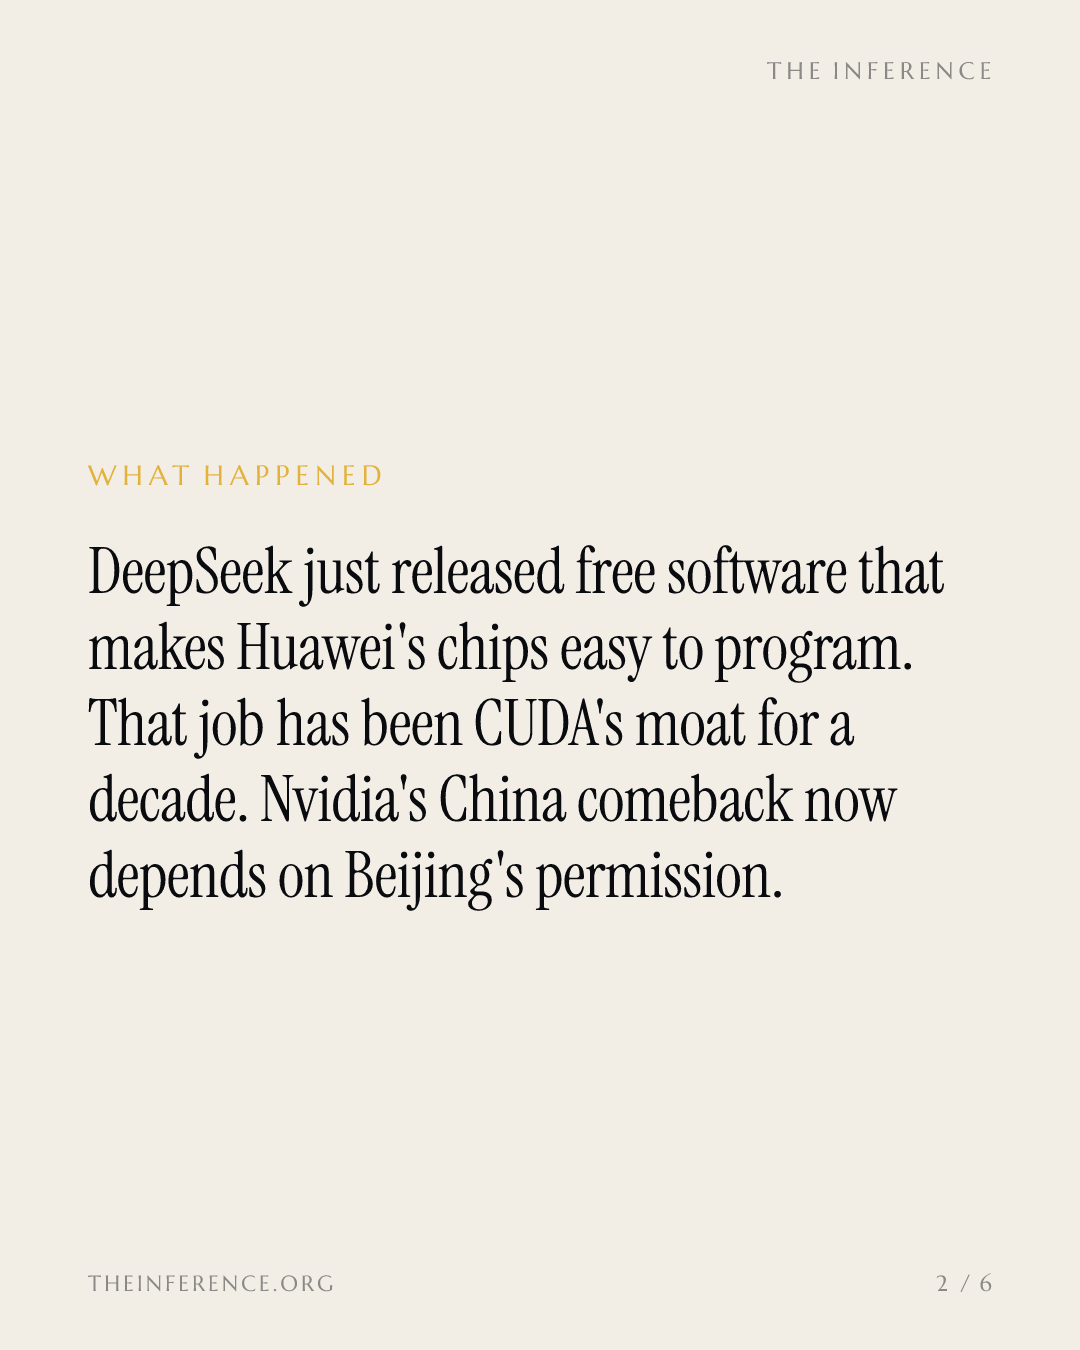
周三,DeepSeek开源了六款面向华为昇腾AI芯片的软件模块1。这套软件瞄准的,正是北京芯片攻坚中无法靠买解决的那一层:让芯片变得可编程的软件。本刊此前报道过押注华为产线的那场豪赌,如今,这场赌注已经产出了可交付的代码。
彭博社称,此次发布的TileLang是中国对标CUDA之作,并且像套件中的其他组件一样免费开放下载2。截至周三,TileLang代码仓库已正式将华为昇腾950列为受支持的后端,并提供原生代码生成与自动调度3。
瓶颈在算子,不在晶体管
AI芯片的成色,取决于算子——那些手工调优的矩阵乘法与注意力代码,性能的高下就在这里分出;这门手艺,十年来一直是CUDA的看家本领。TileLang把这项工作大幅压缩:只需用类Python语法把算子写一遍,编译器就能为英伟达、AMD、苹果的芯片以及如今的昇腾生成优化代码3。
DeepSeek还搭配了负责矩阵乘法的DeepGEMM,以及负责在华为超级节点内128颗昇腾950处理器之间搬运数据的DeepEP;这套软件正是在该超级节点上完成调优的。按DeepSeek自测,性能已逼近硬件极限14。
DeepSeek自家工作负载早已跑通
这不是一套演示用的软件栈。针对DeepSeek V4工作负载的TileLang示例,今年5月起就已进入代码仓库3;4月以来,该实验室一直在昇腾上运行V4推理,并得到华为的全力支持1;华为还为软件开发提供了大量技术协助4。
华为表示,昇腾950超级节点已投入商用,较老的910C超级节点部署量超过1000套5;昇腾960DT训练芯片则提前到2027年第一季度推出,比原计划早了三个季度1。今天做推理,明年做训练——这套软件栈如今覆盖了中国实验室算力账单的两半。
国产芯片的热销,跑在了软件前面
需求从来不是瓶颈。寒武纪上半年营收同比增长108%,至60亿元;同期海光预计营收最高93亿元,摩尔线程预计最高17.5亿元——增长动力来自北京力推的芯片自主可控与美国出口管制6。寒武纪、摩尔线程以及阿里巴巴旗下的平头哥此前均已确认,各自芯片可以运行DeepSeek的模型1。
更能说明问题的是,收入赶在了工具前面:买家下单并没有等软件到位。TileLang的代码仓库中已包含针对摩尔线程和海光硬件的后端3,周三发布的版本则为昇腾补齐了算子、编译器和通信库1。对在供应受计量管控的英伟达硬件与国产芯片之间做选择的中国买家来说,等待的最后一个理由已经消失。
国产芯片厂商在DeepSeek软件到来前就已放量
- 2026年上半年营收
- Estimate
Data
| 2026年上半年营收 | |
|---|---|
| 海光 (estimate) | ¥9.3B |
| 寒武纪 | ¥6B |
| 摩尔线程 (estimate) | ¥1.75B |
英伟达的中国前景,如今只系于一纸许可
英伟达对本季度的营收指引为1080亿美元,前提是假设没有来自中国的数据中心计算收入7。黄仁勋此前表示,英伟达在中国AI芯片市场的份额已从约95%跌至零7。但上一季度,公司来自总部位于中国的客户的收入仍有79亿美元,其中几乎没有AI计算业务7。
押注中国市场重启的看多逻辑有两大支柱:一是北京的“水表”,据报道正以字节跳动和阿里巴巴可能获批采购RTX Pro 5500的方式试运行8;二是所谓CUDA“高不可攀”的论断。前者是政治问题。后者如今在代码仓库里有了覆盖多家厂商的反例。在中国以外的市场,CUDA的工具链依然占优,但软件差距曾是出口管制唯一无法弥合的看空逻辑,而本周,这道差距已在代码层面弥合。
接下来有两个确认信号值得关注:一是中国某家实验室在昇腾上开展前沿模型训练,二是昇腾960DT如约在第一季度亮相1。前者取决于实验室的选择,后者只是一个日期。
回报属于让硬件变得可编程的人
中间层的工作,DeepSeek和华为是自己动手、公开完成的,价值理应归于他们:不属于离晶体管最近的人,而属于让硬件变得可编程的人。护城河从来都在软件。中国的答案如今已经公开,而且免费。
Deepdive
AI-generated from this story and its cited sources. Not investment advice.