Intel und Qualcomm verhandeln Berichten zufolge über Tenstorrent – für bis zu zehn Milliarden Dollar
Den gemeldeten Geboten von Intel und Qualcomm für den Chiphersteller liegen Leistungsangaben zugrunde, die der Anbieter selbst veröffentlicht hat – und jeder Bieter kann sie inzwischen zum Spottpreis testen, bevor er unterschreibt.
 Richard Tang · 3 min read
Echtzeit-Sprach-KI hat in diesem Monat ein Preisschild bekommen – und es ist niedrig genug, um Kapital zu bewegen. Am 2. Oktober 2026 hat das Sprach-KI-Forschungslabor Smallest.ai sein Sprachmodell Lightning V2 auf die Galaxy-Blackhole-Server von Tenstorrent~$2.6B — Tenstorrent, private, latest valuation ~$2.6B gebracht; abgerechnet wird nutzungsbasiert und ohne Vorabverpflichtung 1. Das technische Paper zum Start kommt zu dem Ergebnis, dass dieselbe Workload rund ein Viertel der Beschleunigerkosten einer Nvidia−1.59% — Nvidia, down 1.59 percent today L40S verursacht 2.
Die Behauptung stammt vom Anbieter selbst und ist nicht verifiziert – genau deshalb ist sie wichtig. Intel−6.29% — Intel, down 6.29 percent today und Qualcomm−3.81% — Qualcomm, down 3.81 percent today bieten Berichten zufolge bis zu zehn Milliarden Dollar für Tenstorrent – ein Preis, den jeder Bieter inzwischen testen kann, bevor er unterschreibt 34.
Der Preisvorteil musste ins Modell eingebaut werden
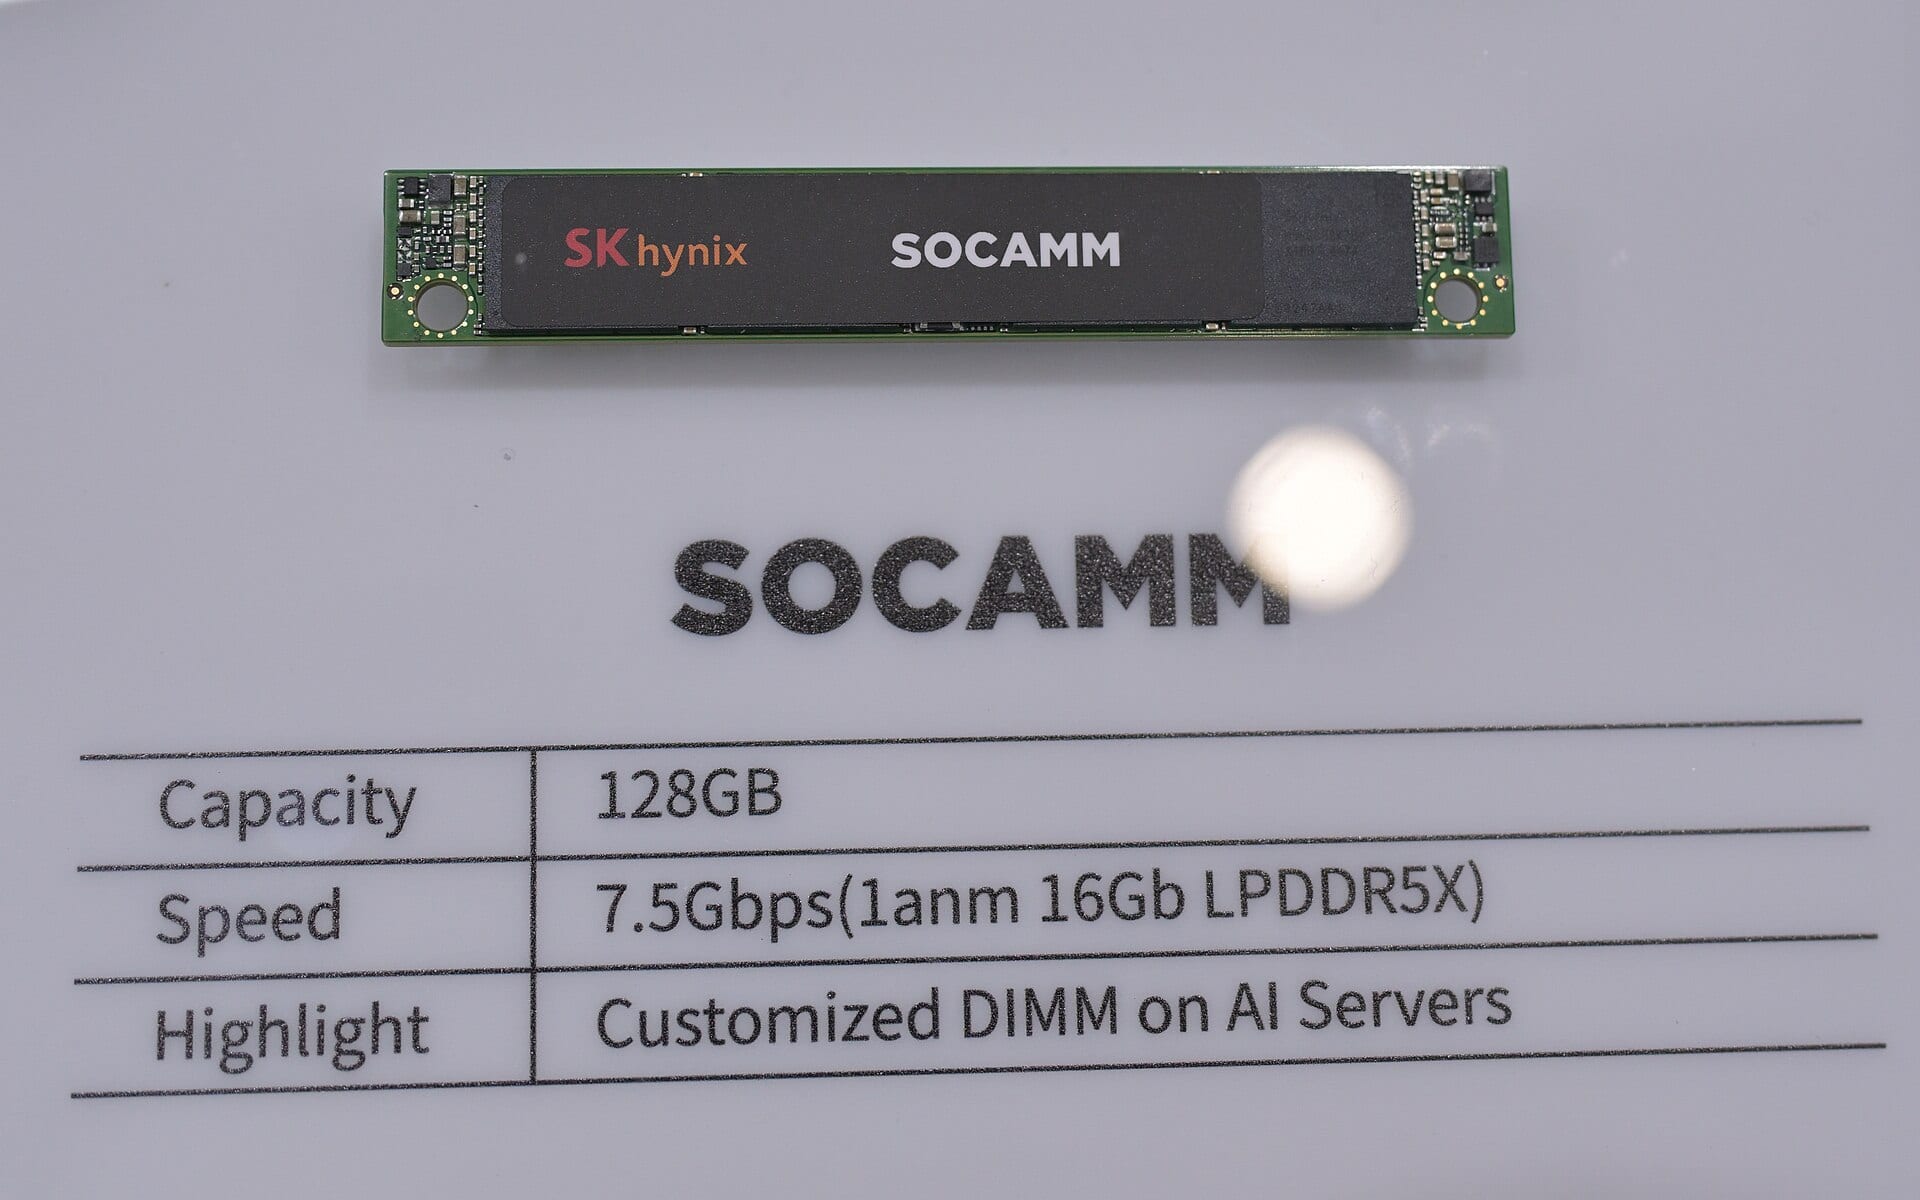
Tenstorrents Vorteil beginnt in der Arithmetik. Seine Blackhole-Chips beherrschen BlockFloat8, ein Zahlenformat mit acht Bit, nativ auf Silizium, das im Listenpreis bei rund 1.000 Dollar pro Chip liegt; GPUs mit nativer Unterstützung für dieses Format kosten, so die Autoren des Papers, rund 40.000 Dollar 5. Sprache ist der schwierige Fall: Text-to-Speech-Modelle erzeugen kontinuierliche Wellenformen, und kleine numerische Fehler schaukeln sich über die Denoising-Schritte zu hörbaren Artefakten auf 2.
Smallest.ai hat Lightning V2 so umgebaut, dass mehr als 80 Prozent des Modells in diesem Acht-Bit-Format laufen, und über das interne Speichernetzwerk des Chips die Datenbewegung verringert; das Audio hielt stand: ein Abstand von 0,071 Punkten beim perzeptuellen Score gegenüber der L40S, den die Autoren als geringfügige Abweichung einordnen 25.
Der Flottenrabatt beruht teils auf Hochrechnung
Im Flottenmaßstab, bei 550 gleichzeitigen Anfragen von je fünf Sekunden, kalkulieren die Autoren einen Bedarf von rund 100.000 Dollar an L40S-Karten oder rund 27.000 Dollar an P100-Chips von Tenstorrent 5. Die Latenzangabe der P100 allerdings wurde von gemessenen P150-Ergebnissen übernommen, die günstigere Flottenzahl beruht also teils auf nicht gemessener Latenz 5. Wo die Messung endet und die Hochrechnung beginnt, zeigen Schichten, die numerisch zu empfindlich für eine Quantisierung sind, und ein Compiler, der noch nicht vollständig optimiert ist 5.
Eine Sprach-Workload, zwei Rechnungen: 100.000 Dollar L40S oder 27.000 Dollar Tenstorrent P100
- Estimate
Data
| Value | |
|---|---|
| Nvidia L40S (estimate) | $100k |
| Tenstorrent P100 (estimate) | $27k |
| Tenstorrent P150 (estimate) | $37k |
Japan wiederholte das Muster bei Sprachmodellen
Japan lieferte noch am selben Tag einen zweiten Datenpunkt. Fixstars, ein auf Performance-Engineering spezialisiertes Unternehmen aus Tokio, und Macnica, ein an der Tokioter Börse notierter Chip-Distributor (TSE: 3132), haben das Open-Weight-Modell gpt-oss-120b auf einer Tenstorrent-Workstation optimiert 67. Ein zentraler Schritt der Matrixmultiplikation lief um den Faktor 3,68 schneller, und die Generierungszeit je Token sank von 144,85 auf 99,49 Millisekunden – ein Rückgang um 31 Prozent 6. Die Portierung von Modellen auf diese Silizium-Chips verkauft Macnica bereits als abrechenbare Dienstleistung 7.
Die Gebote bepreisen ein Token, das niemand unabhängig gemessen hat
Tenstorrent erreichte mit Galaxy Blackhole am 28. April 2026 die allgemeine Verfügbarkeit und nahm im August desselben Jahres eine Series-E-Runde über 1,29 Milliarden Dollar ein 48. Bloomberg berichtete von frühen Gesprächen mit Intel und Qualcomm über mindestens 5 Milliarden Dollar, und The Information, inzwischen von Reuters bestätigt, bezifferte einen Qualcomm-Deal auf 8 bis 10 Milliarden Dollar; abgeschlossen ist bislang keiner 34. Nvidias KI-Silizium erzielt Margen von über 70 Prozent, und ein Kostenvorteil, der die Überprüfung übersteht, ist die Rechnung, die diese Margen drücken würde 4.
Die Überprüfung ist das fehlende Kettenglied. Umfassende unabhängige Benchmarks zu Tenstorrent auf Produktions-Workloads gibt es bislang nicht, und Stacy Rasgon, Analyst bei Bernstein, warnt, dass ein Käufer womöglich den Tenstorrent-Chef Jim Keller einkauft – einen Architekten, der große Konzerne erfahrungsgemäß nach wenigen Jahren wieder verlässt 4. Jeder Bieter kann die Workload jetzt laufen lassen und die Rechnung lesen, bevor er unterschreibt – und diese Rechnung wird den Streit entscheiden.
Deepdive
AI-generated from this story and its cited sources. Not investment advice.