Modal migre 300 millions de dollars de travail d'agents IA vers le processeur Vera de Nvidia, au débit jusqu'à deux fois supérieur d'après ses propres tests
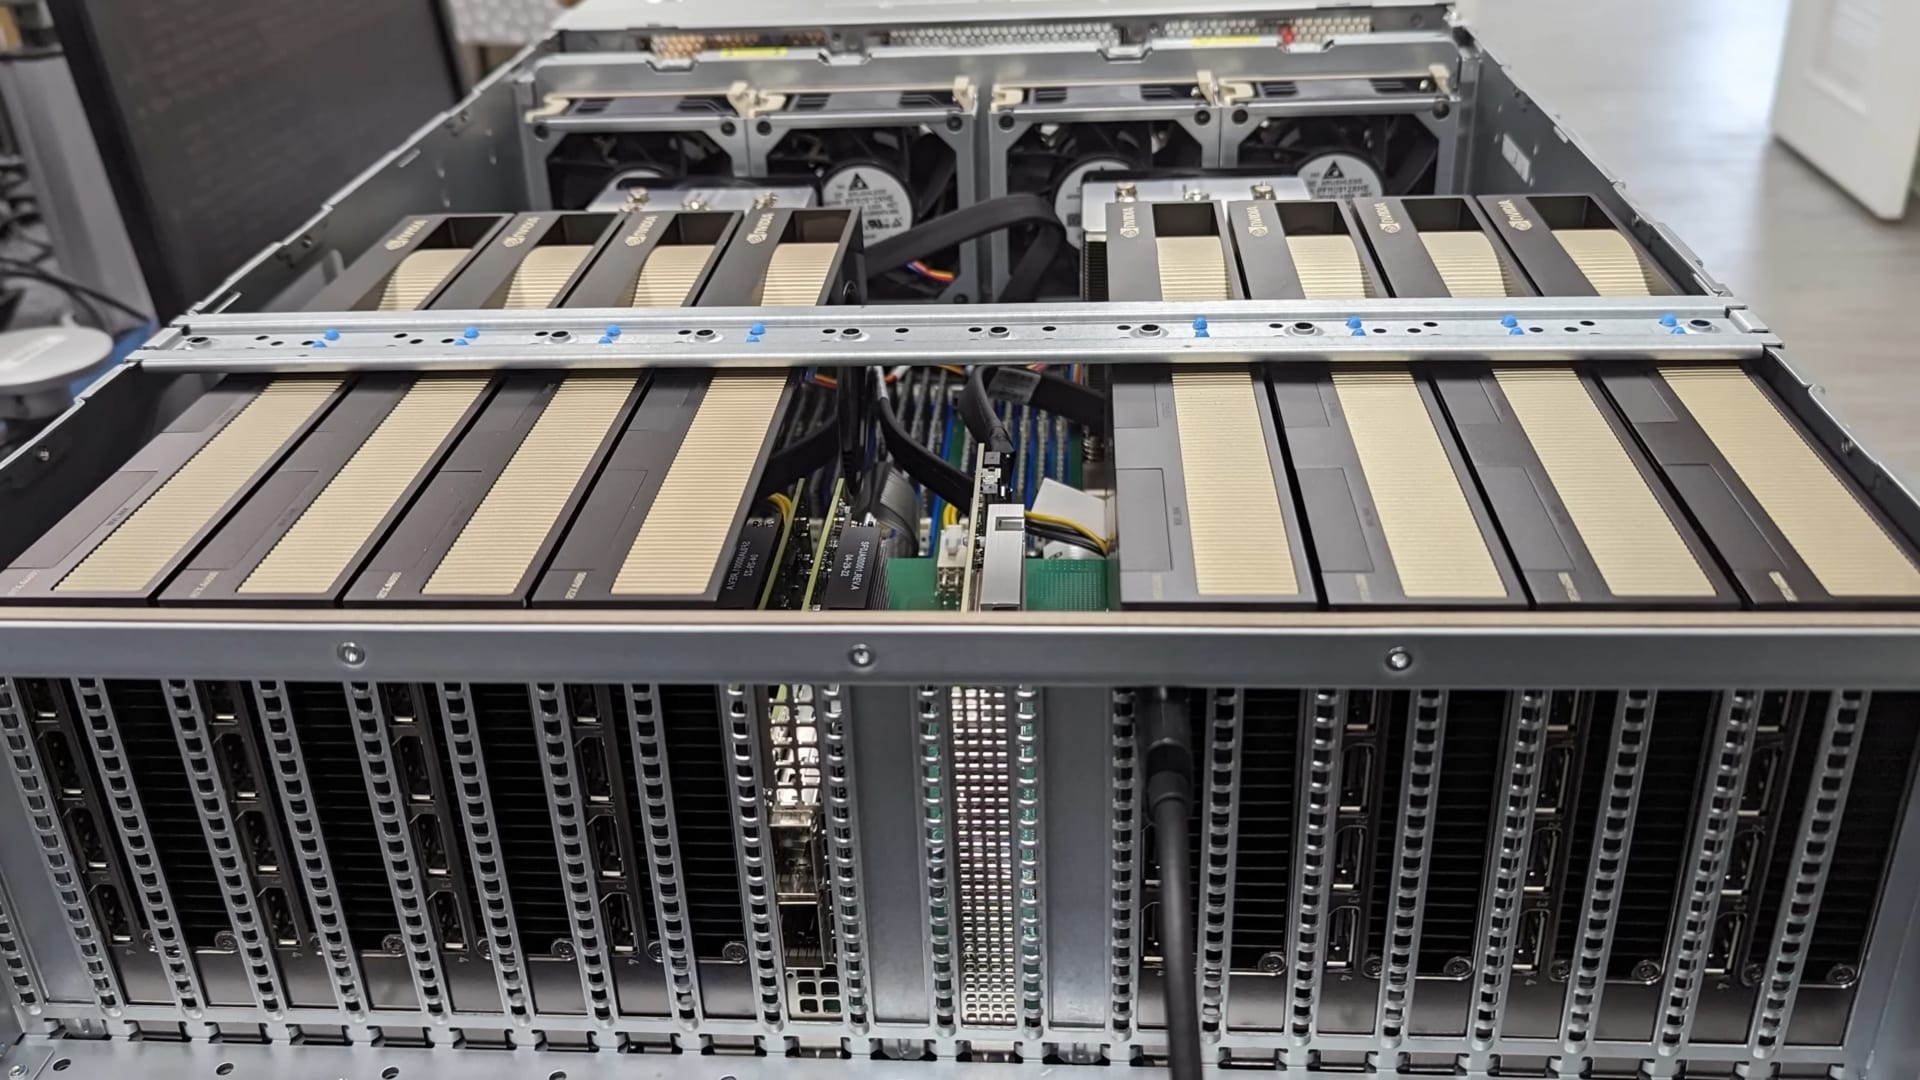
Modal va faire tourner sur le processeur Vera de Nvidia, fondé sur l'architecture Arm, le produit qui lui rapporte 300 millions de dollars par an. Sur un serveur rempli de conteneurs, ses propres tests ont mesuré un débit jusqu'à deux fois supérieur à celui d'une machine Intel. La raison avancée — les GPU restent inactifs tant que le travail du CPU n'est pas terminé — transforme un choix de processeur en décision sur ce que rapportent les puces les plus chères.
 Richard Tang · 3 min read
Modal$87M — Modal, private, latest valuation $87M migre ses bacs à sable d'agents vers le processeur Vera de Nvidia+1.92% — Nvidia, up 1.92 percent today, fondé sur l'architecture Arm+0.88% — Arm, up 0.88 percent today. C'est la première fois que la société s'écarte des puces Intel−0.21% — Intel, down 0.21 percent today et AMD+2.23% — AMD, up 2.23 percent today sur lesquelles elle a toujours tourné. La décision fait suite à un benchmark maison montrant, sur un serveur rempli de conteneurs, un débit de tâches jusqu'à deux fois supérieur 1.
Un tiers environ du chiffre d'affaires de l'entreprise se joue sur cette couche. Les bacs à sable, ces ordinateurs isolés où les agents IA écrivent et exécutent du code, pèsent 300 millions de dollars sur le milliard de dollars de revenus annualisés que revendique Modal, et près de 3 milliards en ont déjà été créés 12. La raison invoquée par Modal tient à l'utilisation : en apprentissage par renforcement, les GPU, coûteux, restent souvent inactifs tant que le travail du CPU n'est pas achevé 1.
Pourquoi le CPU décide de ce que gagnent les GPU
Selon Modal, la plupart des configurations d'entraînement restent synchrones. Chaque rollout — une tentative complète du modèle sur une tâche, dont l'issue devient signal d'apprentissage — passe une partie de son temps sur le CPU, et l'ensemble des rollouts doit être terminé avant que les GPU inactifs ne passent à l'étape suivante : tout temps gagné sur le CPU est donc un temps gagné sur le GPU 3. Le processeur bon marché décide ainsi de l'utilisation que l'on fait du processeur coûteux. Un CPU plus rapide achète, en pratique, des heures de GPU.
Le travail des agents va par à-coups, et la bande passante de Vera les absorbe
Les locataires des bacs à sable sont bruyants : un agent reste inactif dans l'attente d'un modèle de langage, puis tire dix fois sa puissance de calcul habituelle pendant l'installation d'un logiciel ; ils sont des centaines à partager un même hôte, et la pointe d'un client peut ralentir le travail d'un autre 1.
Dans le benchmark de Modal, portant sur 50 tâches de codage, Vera devance les puces Intel, AMD et Amazon−0.32% — Amazon, down 0.32 percent today tâche par tâche, mais de peu. L'écart se creuse en charge : Vera tient son rythme à mesure que les conteneurs s'accumulent, quand les autres se heurtent à un plafond — une tenue que Modal attribue à la bande passante mémoire de Vera 13. Le résultat est celui de Modal seule et n'a pas fait l'objet d'une vérification indépendante 1.
La prime se déplace de l'isolation vers la boucle d'entraînement
Modal a levé 750 millions de dollars le 14 octobre, à une valorisation de 15,75 milliards de dollars, et précise que cette somme achète des couches plus hautes, dont l'apprentissage par renforcement et des outils de post-entraînement 2. Le cloud concurrent Together AI~$3.3B — Together AI, private, latest valuation ~$3.3B a ouvert précisément cette couche le 19 octobre : des GPU B200 réservés, une boucle d'entraînement définie par le client, le tout à un tarif de lancement de 9 dollars par heure de GPU 45.
La couche située en dessous, elle, se banalise : Perplexity a open-sourcé son bac à sable de production, SPACE, et CoreWeave−2.35% — CoreWeave, down 2.35 percent today, Akamai+0.69% — Akamai, up 0.69 percent today et Crusoe$26.61B — Crusoe, private, latest valuation $26.61B le proposent déjà 68. Les studios d'agents continuent de payer à Modal environ 41 % de plus par heure de CPU virtuel qu'à E2B ou Daytona pour cette isolation 6.
Soit environ trois fois le tarif de calcul ordinaire que Modal facture elle-même 6. La société loue sa capacité auprès de plus de vingt clouds et ne possède aucun datacenter : une puce qui double la densité de conteneurs par serveur fait grimper ce que rapporte chaque serveur loué 2.
Intel et AMD jouent leur socket
Nvidia a lancé Vera en mars, un CPU conçu pour les agents et doté de 88 cœurs, en citant Anthropic$350B — Anthropic, private, latest valuation $350B et OpenAI$1.18T — OpenAI, private, latest valuation $1.18T parmi ses premiers utilisateurs 1. Alibaba Cloud, ByteDance, CoreWeave, Nebius−2.06% — Nebius, down 2.06 percent today et Oracle−2.15% — Oracle, down 2.15 percent today figurent parmi les clouds qui prévoient de le déployer 3. Le gain revient deux fois à Nvidia : une première fois dans le CPU, une seconde fois dans les GPU qu'il maintient occupés, tandis qu'Intel et AMD perdent le socket qu'ils détenaient par défaut dans la seule couche où les agents exécutent du code.
Le doublement n'est qu'une allégation tant qu'il ne tourne pas en production
Modal ne fixe pas de date pour la bascule de ses clients sur Vera. Nvidia, de son côté, indique que la puce sera disponible chez les partenaires au second semestre 2026 13. Modal se couvre aussi : Intel et AMD restent en rotation, et chaque tâche est aiguillée vers la puce qui l'exécute le mieux 7. Ce qui tranchera, c'est de savoir si le gain sur serveur rempli de conteneurs tiendra en dehors du propre benchmark de Modal, et si la prime de 41 % survivra à une couche d'isolation désormais gratuite 6.
Get Data Center by email, free
Who is building AI's data centers, and who is paying for them. In our daily email, every weekday.