Modal、年3億ドルのAIエージェント処理をエヌビディアのCPU「ベラ」に移す 自社試験で最大2倍のスループット
Modalは年3億ドルを生み出す事業を、エヌビディアのアームベースのCPU「ベラ」で動かす。自社試験で、コンテナを詰め込んだサーバーのスループットがインテル製マシンの最大2倍に達したためだ。理由として同社が挙げるのは、CPU側の処理が終わるまで高価なGPUが遊んでしまうという説明で、これによりCPUの選定は、高価なチップがどれだけ稼ぐかを決める問題に変わる。
 Richard Tang · 3 min read
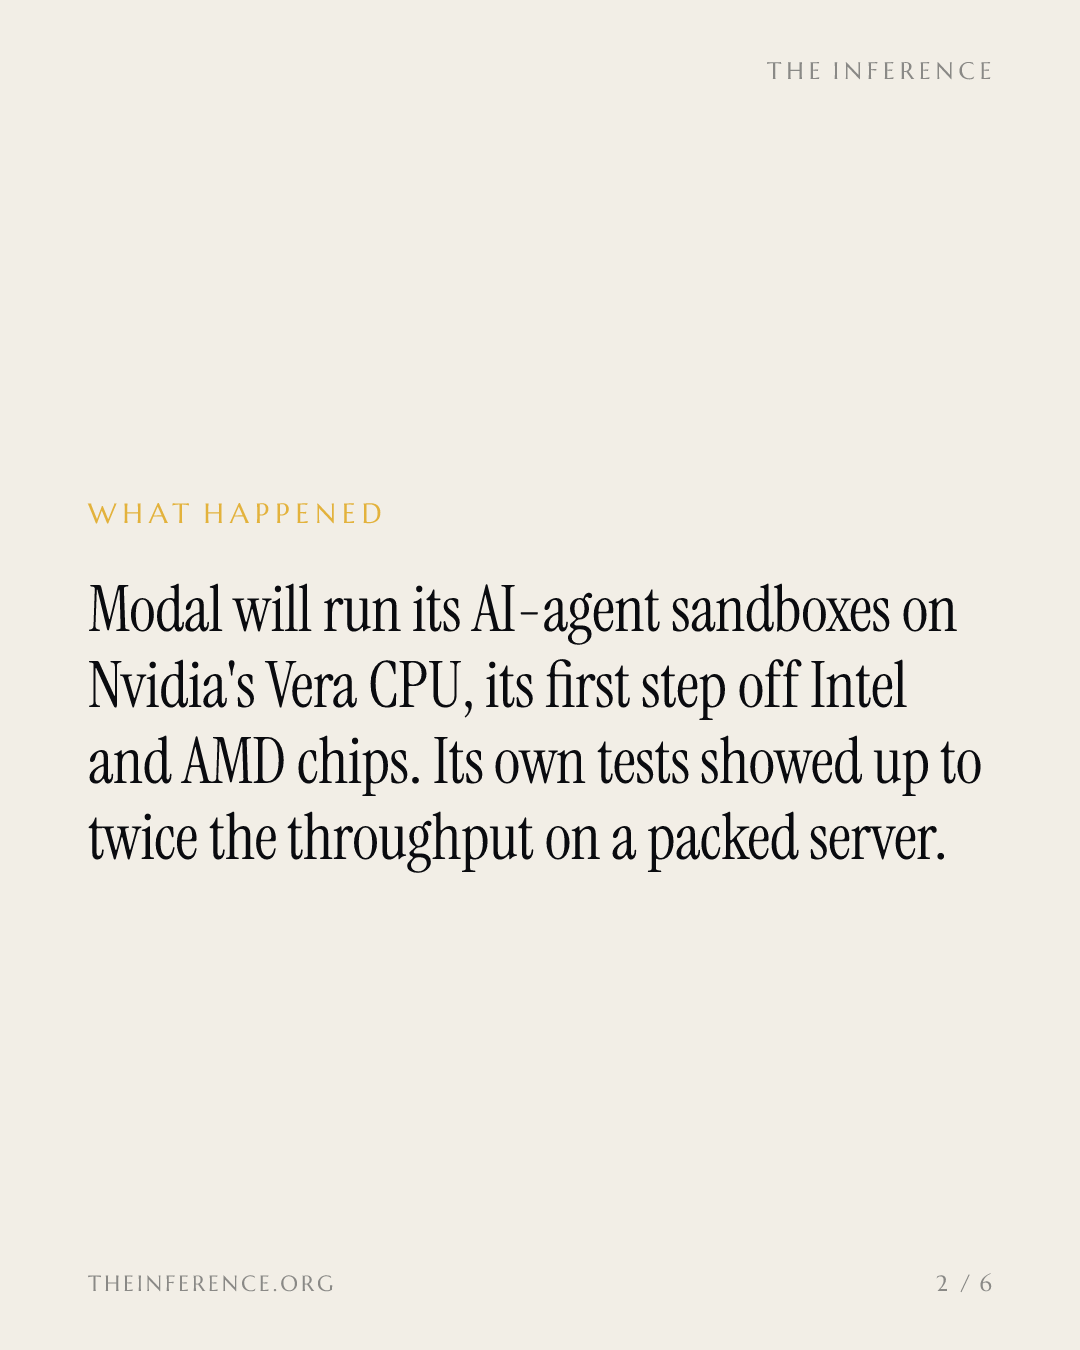
Modal$87M — Modal, private, latest valuation $87Mはエージェントサンドボックスをエヌビディア+1.92% — エヌビディア, up 1.92 percent todayのアーム+0.88% — アーム, up 0.88 percent todayベースのCPU「ベラ(Vera)」に移す。コンテナを詰め込んだサーバーでタスクのスループットが最大2倍に達したとする自社ベンチマークの結果を踏まえた判断で、これまで使い続けてきたインテル−0.21% — インテル, down 0.21 percent todayとAMD+2.23% — AMD, up 2.23 percent todayのシリコンから初めて離れる一歩となる1。
この層に、同社の売上高の約3分の1がかかる。サンドボックスは、AIエージェントがコードを書き、実行するための隔離されたコンピューターで、Modalが公表する年換算10億ドルのうち年3億ドルを稼ぐ。累計作成数は30億個近くに上る12。Modalが移管の理由として挙げるのは稼働率の問題だ。強化学習では、CPU側の処理が終わるまで高価なGPUが遊んでしまうことが多いという1。
なぜCPUがGPUの稼ぎを左右するのか
Modalによると、学習環境の大半は今も同期的だ。1回のロールアウト(モデルが課題に取り組む完結した1回の試行で、その結果が訓練シグナルになる)にはCPUで処理する時間が含まれ、一連のロールアウトがすべて終わるまで、アイドル状態のGPUは次のステップに進めない。CPUで節約した時間は、そのままGPUで節約した時間になる3。だから、安いプロセッサーが高いプロセッサーがどれだけ使われるかを決める。速いCPUは、事実上GPUの稼働時間を買っているのと同じだ。
変動の激しいエージェント処理、ベラの帯域幅が吸収
サンドボックスの利用者は騒がしい。エージェントは言語モデルの応答を待つ間は静かにしているかと思えば、ソフトウエアのインストール時には普段の10倍の計算力を引き出す。1台のホストを数百の利用者が共有するため、ある顧客の急増した負荷が、別の顧客の処理を遅らせることがある1。
Modalが50のコーディング課題で実施したベンチマークでは、課題を1つずつ動かした場面でベラはインテル、AMD、アマゾン−0.32% — アマゾン, down 0.32 percent todayのチップを上回ったが、差はわずかだった。差が開いたのは高負荷時だ。コンテナが積み重なってもベラはペースを維持し、他のチップは頭打ちになった。Modalはこの差をベラのメモリー帯域幅によるものとしている13。結果はModal独自のもので、第三者による検証は受けていない1。
付加価値は隔離から学習ループへ移る
Modalは10月14日、企業価値157億5000万ドルの評価で7億5000万ドルを調達した。調達した資金でより上位の層を獲得するとしており、強化学習やポストトレーニング(事後学習)のツールなどが例に挙がった2。競合クラウドのTogether AI~$3.3B — Together AI, private, latest valuation ~$3.3Bは10月19日、まさにその層の提供を始めた。提供するのは専有予約のGPU「B200」で、学習ループは顧客自身が定義する。導入価格はGPU1時間あたり9ドル45。
その下の層はコモディティー化が進む。パープレクシティ(Perplexity)が本番運用する自社サンドボックス「SPACE」をオープンソース化し、コアウェイブ(CoreWeave)−2.35% — コアウェイブ(CoreWeave), down 2.35 percent today、アカマイ+0.69% — アカマイ, up 0.69 percent today、クルーソー(Crusoe)$26.61B — クルーソー(Crusoe), private, latest valuation $26.61Bがすでに同じ層を提供している68。エージェント開発企業は今も、その隔離の対価として、仮想CPU1時間あたりE2BやDaytonaより約41%高い料金をModalに払い続けている6。
この価格水準は、Modal自身の通常の計算料金の約3倍にあたる6。Modalは20社を超えるクラウドから処理能力を借りて運用しており、データセンターは自社で持たない。それだけに、詰め込み密度を2倍にできるチップは、借りているサーバー1台が生み出す収入を増やすことになる2。
インテルとAMDが負うソケットのリスク
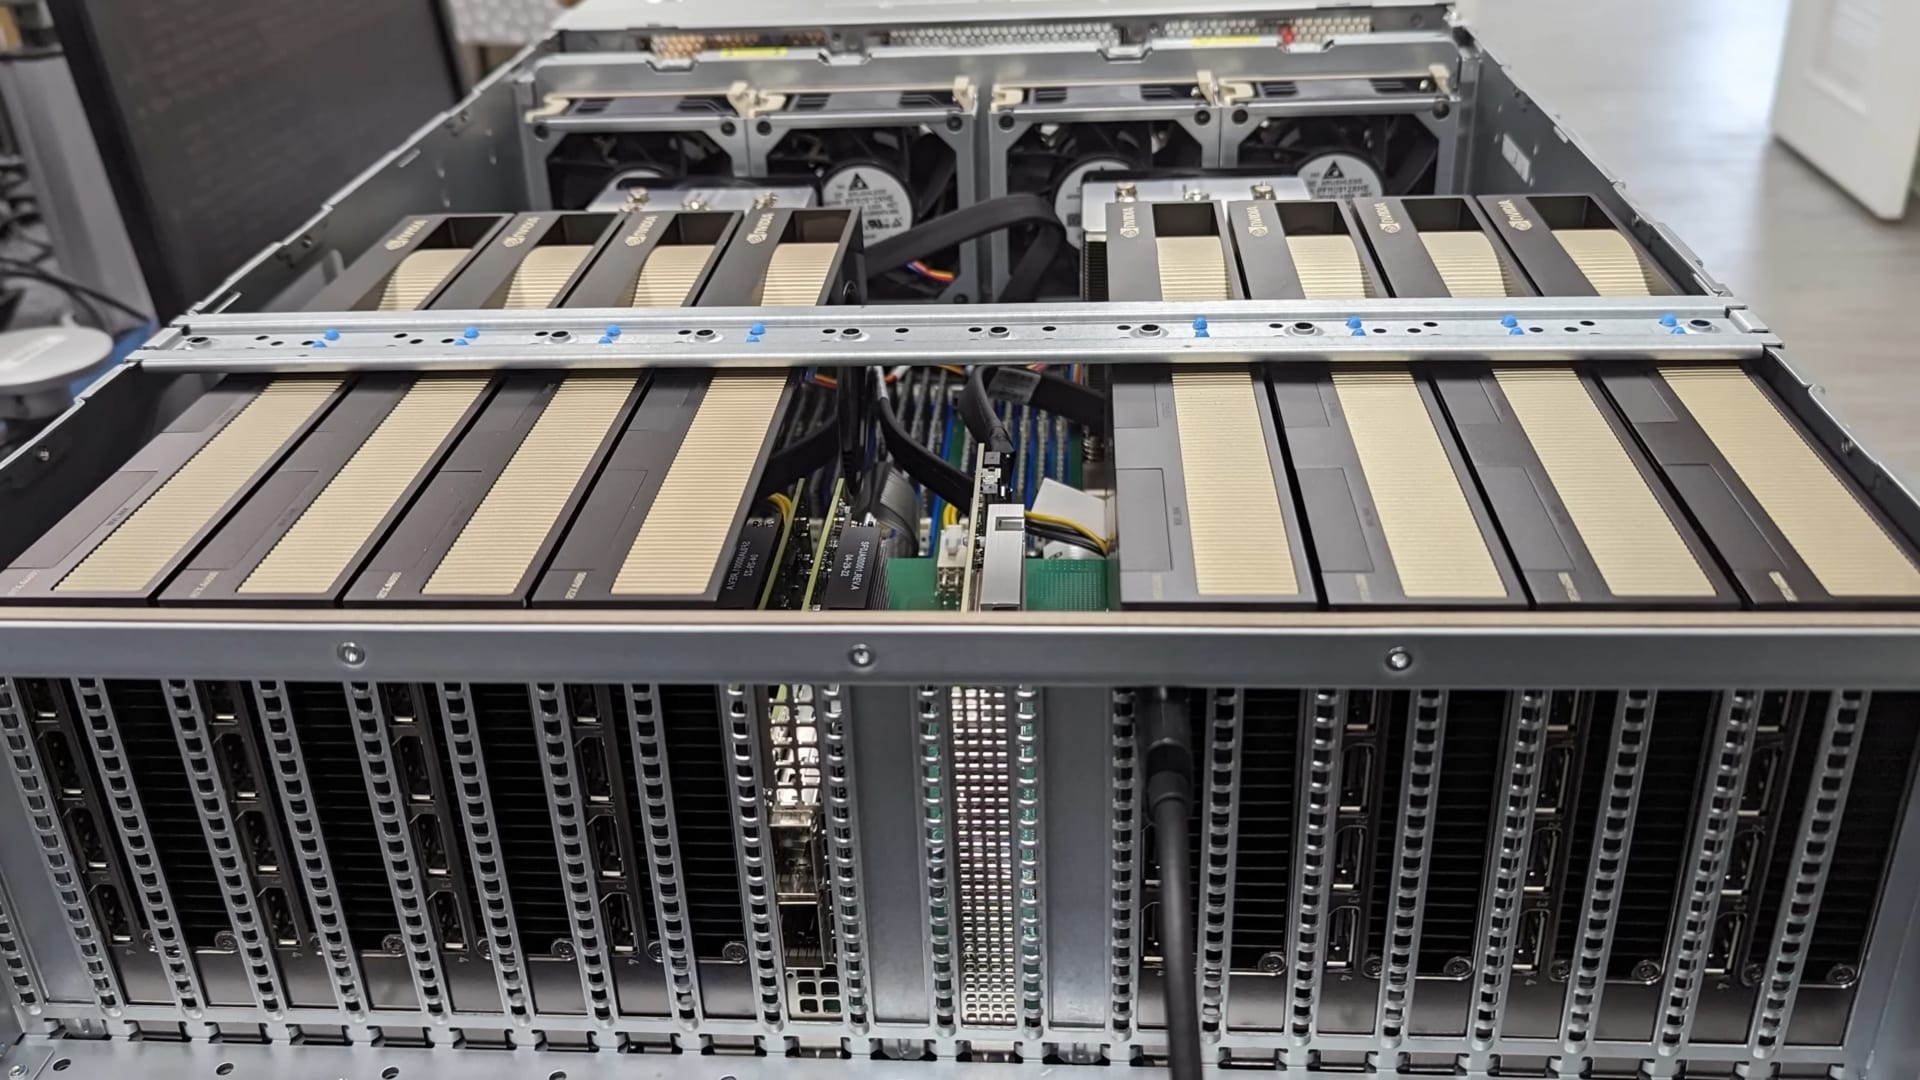
エヌビディアは3月、エージェント向けに設計した88コアのCPU「ベラ」を投入し、初期の利用者としてアンソロピック$350B — アンソロピック, private, latest valuation $350BやオープンAI$1.18T — オープンAI, private, latest valuation $1.18Tの名を挙げた1。導入を計画するクラウドには、アリババクラウド、バイトダンス、コアウェイブ、ネビウス(Nebius)−2.06% — ネビウス(Nebius), down 2.06 percent today、オラクル−2.15% — オラクル, down 2.15 percent todayなどが名を連ねる3。利得はエヌビディアに二重に入る。CPUで一度、そしてベラがフルに稼働させ続けるGPUでもう一度だ。一方、エージェントがコードを動かす唯一の層で、インテルとAMDは、これまで何もしなくても握れていたソケットを失う。
実運用まで「2倍」は主張にすぎない
モーダルは、顧客のワークロードがベラに移る時期を明らかにしていない。エヌビディアはパートナー経由での提供を2026年下半期に開始するとしている13。モーダルも保険をかける。インテルとAMDをラインナップに残し、ジョブごとに最もうまく動くチップへ割り振っている7。見極めの分かれ目は、コンテナを詰め込んだサーバーでのスループット向上がモーダル自身のベンチマークの外でも成り立つかどうかと、今や無料で手に入る隔離層を前に、その41%の付加価値が生き残れるかどうかだ6。
Get Data Center by email, free
Who is building AI's data centers, and who is paying for them. In our daily email, every weekday.