اختبار «مايو كلينك»: خطابات OpenEvidence للموافقة المسبقة ليست أفضل من نظيراتها في ChatGPT.. و15 مليار دولار تشتري الانتشار
مقارنة مباشرة قادتها «مايو كلينك» ودراسة في مجلة «نيتشر ميديسين» (Nature Medicine) وضعتا جودة إجابات OpenEvidence موضع التوثيق في أسبوع واحد: جيدة بما يكفي للاستخدام، لكنها لم تعد الأفضل وحدها. فعند تقييم 15 مليار دولار، يدفع المستثمرون ثمن الانتشار، والانتشار لم يعد وحيداً في الساحة.
 Vincent Jiang · 3 min read
الوثيقة الأكثر قيمة في الطب الأمريكي قصيرة وبلا بريق، وهي التي تقرر ما إذا كانت شركة التأمين ستدفع ثمن الدواء أم لا: رسالة الموافقة المسبقة (Prior Authorization). وفي «أسبوع الكلى» (ASN Kidney Week) الذي تعقده الجمعية الأمريكية لأمراض الكلى في دنفر هذا الأسبوع، اختبر فريق تقوده «مايو كلينك» من الأداتين تصيغ هذه الرسائل بشكل أفضل، OpenEvidence~$6B — OpenEvidence, private, latest valuation ~$6B أم ChatGPT-5، عبر 28 سيناريو في أمراض الكلى 1.
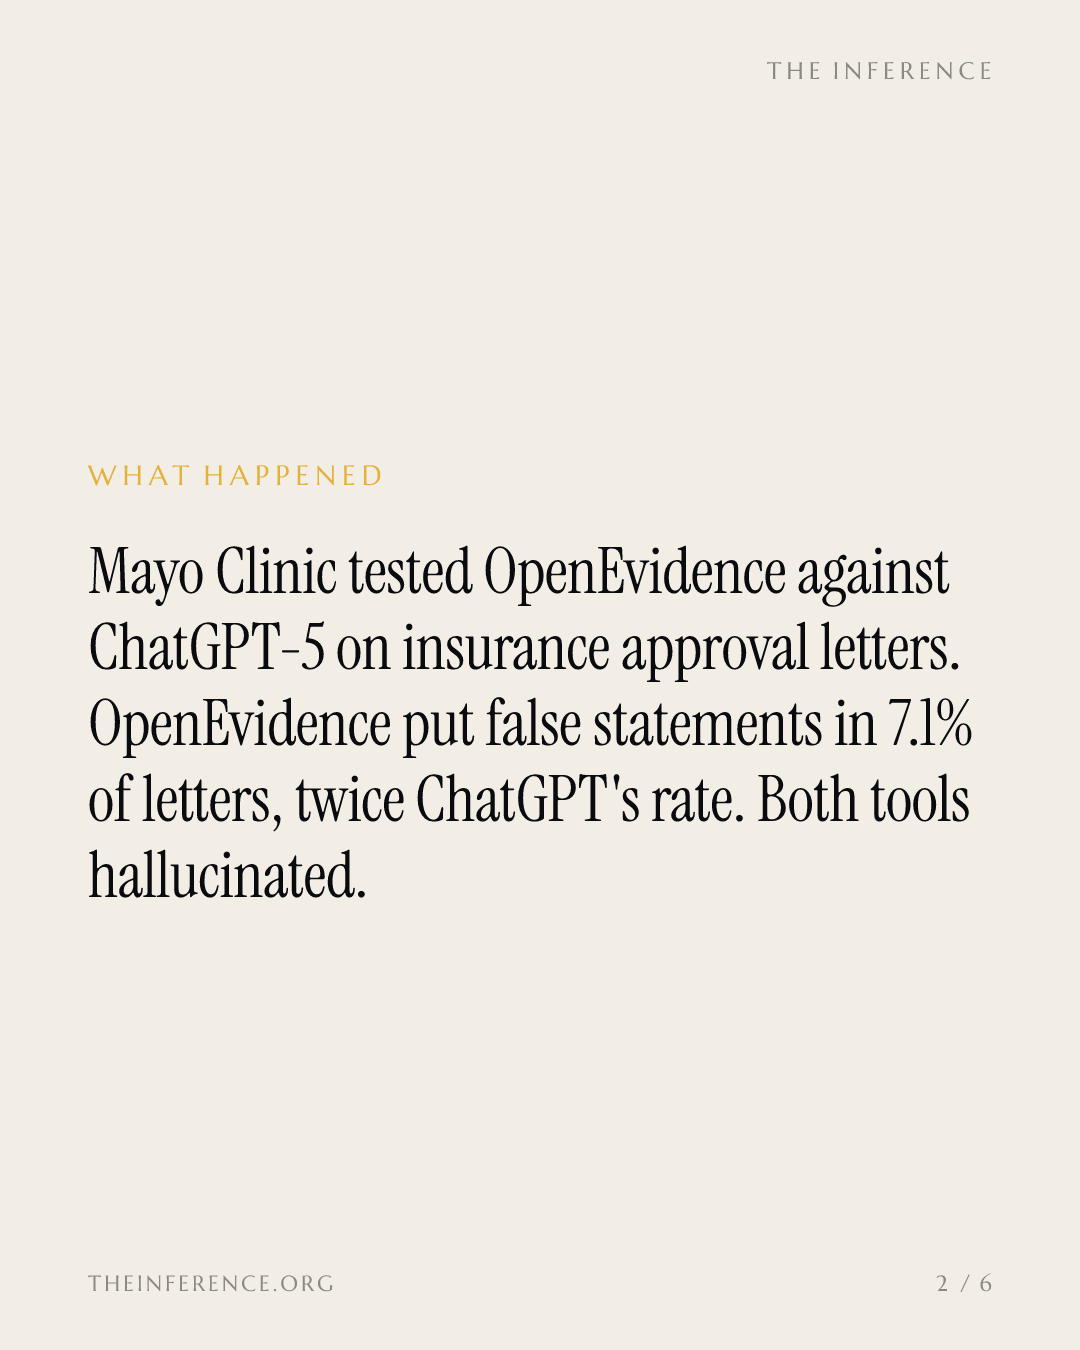
OpenEvidence، محرك الإجابات بالذكاء الاصطناعي الذي يستخدمه 65% من أطباء الولايات المتحدة، تضمنت خطاباته عبارات كاذبة في 7.1% منها مقابل 3.6% لخطابات ChatGPT-5، فيما حصل استدلاله السريري على تصنيف «قوي» في 78.6% من الخطابات مقابل 89.3% 1. وكان ترميز التصنيف الدولي للأمراض (ICD-10) صحيحاً في 67.9% من خطابات OpenEvidence مقابل 78.6% لخطابات ChatGPT-5، وربط فريق مايو هذا الفارق بطول الخطاب: خطابات OpenEvidence كانت أطول وتجاوزت في كثير من الأحيان سقف الـ350 كلمة المستهدف، والمزيد من الكلمات يعني مزيداً من فرص الوقوع في الخطأ 1.
تراجع OpenEvidence أمام ChatGPT-5 في جميع معايير جودة الخطابات، من دون فارق دال إحصائياً في أي منها
- OpenEvidence
- ChatGPT-5
Data
| OpenEvidence | ChatGPT-5 | |
|---|---|---|
| عبارات كاذبة | 7.1 | 3.6 |
| استدلال سريري قوي | 78.6 | 89.3 |
| ترميز ICD-10 صحيح | 67.9 | 78.6 |
لم يبلغ أي من هذه الفروق حد الدلالة الإحصائية، وجاء استنتاج الباحثين متزناً: هذه مسودات على طبيب مراجعتها، وليست خطابات نهائية. وقد سجلت كلتا الأداتين هلوسات 1.
ما على المحك: قرار رفض يمكن كسب التظلم عليه لكنه يُترك
أصدرت شركات التأمين في برنامج «ميديكير أدفانتج» (Medicare Advantage) 52.8 مليون قرار موافقة مسبقة عام 2024، ورفضت 4.1 مليون منها (بنسبة 7.7%)، فيما لم يُقدَّم تظلم إلا بشأن 11.5% فقط من حالات الرفض 210. وعندما لجأ الأطباء إلى التظلم، جرى إلغاء قرار الرفض كلياً أو جزئياً في 80.7% من الحالات 210. فقرار الرفض قابل للنجاح في التظلم في العادة، ومتروك في العادة أيضاً، وهذا تحديداً مسار العمل الذي تُباع فيه كتابة الخطابات بالذكاء الاصطناعي 2.
التقييم يشتري الانتشار.. وسجل الدقة بات يقول ذلك
بلغ تقييم OpenEvidence 15 مليار دولار في سبتمبر/أيلول، بعد جولة تمويل بقيمة 250 مليون دولار بقيادة مشتركة من «أندريسن هورويتز» (Andreessen Horowitz) و«بايرز كابيتال» (Byers Capital)، وهي ثالث زيادة لتقييمها هذا العام، وذلك استناداً إلى إيرادات إعلانية متوقعة تتراوح بين 400 و500 مليون دولار في 2026 من شركات الأدوية 3. وما يشتريه المال هنا هو الانتشار: قدّم 952 ألف كادر طبي 271 مليون استعلام حتى يونيو/حزيران 2026، ووصل عدد المستخدمين النشطين شهرياً إلى 703,265، فيما عالجت المنصة 42 مليون توجيه (Prompt) في أكتوبر/تشرين الأول 311.
لكن ما لا يشتريه هذا المال، وفق السجل المنشور، هو أفضل نموذج. ففي دراسة نشرتها مجلة «نيتشر ميديسين» في يونيو/حزيران، سجّل OpenEvidence دقة 89.6% في 500 سؤال من اختبار MedQA، متأخراً عن Gemini 3.1 Pro الذي حقق 97.4% وعن GPT-5.2 الذي حقق 94.2%. وفي التقييم السريري، وضعه أطباء خضعوا للتعمية (Blinded) على قدم المساواة مع UpToDate Expert AI وخدمة AI Overview من غوغل 4.
في اختبار MedQA، تأخر OpenEvidence عن Gemini 3.1 Pro بفارق 7.8 نقطة
Data
| Value | |
|---|---|
| OpenEvidence | 89.6% |
| Claude Opus 4.6 | 90.2% |
| GPT-5.2 | 94.2% |
| Gemini 3.1 Pro | 97.4% |
الخندق التنافسي هو الشبكة.. وأطرافها ازدحمت هذا الأسبوع
تعمل «ميموريال سلون كيترينغ» على ربط قاعدة بيانات «OncoKB» للجينات الورمية بكل من OpenEvidence وEpic 7. أما OneOncology، التي يعالج أطباء الأورام التابعون لها في مراكز الرعاية المجتمعية 1.5 مليون مريض، فقد دمجت الأداة ضمن مسارات عملها 5.
وفي الأثناء، توصلت شركة Doximity−1.78% — Doximity, down 1.78 percent today، التي تصل إلى أكثر من 85% من أطباء الولايات المتحدة، إلى تسوية في الدعوى التي رفعتها OpenEvidence ضدها في يونيو/حزيران 2025، إذ رُفضت جميع المطالبات نهائياً في 17 أكتوبر/تشرين الأول، على أن يتحمل كل طرف تكاليفه الخاصة 8912. وزعمت OpenEvidence في تلك الدعوى أن موظفي Doximity انتحلوا صفات أطباء، واستخدموا تعليمات مدسوسة لحقن التوجيهات (Prompt Injection) لخداع الأداة ودفعها إلى الكشف عن توجيهات نظامها السرية 89.
بعد يومين من التسوية، أدمجت Doximity خدمة UpToDate التابعة لشركة «ويلتيرز كلوور» (Wolters Kluwer)، التي تضم 13 ألف موضوع خضع لمراجعة خبراء، داخل أداتها المنافسة «Ask»، فارتفع سهمها بنسبة 7.3% 8912. أما الشركة المالكة للمحتوى المرخّص، فهي اليوم تجلس على طرفي الصفقة في آن واحد 8912.
وتعترف دراسة الاستخدام ذاتها بالسؤال المفتوح: فهي تحصي مَن يسأل، لا إن كانت الإجابات صحيحة، ولا إن كانت نتائج المرضى أفضل. فأسئلة العلاج وتدبير الحالات، التي تمثل 33.1% من استعلامات الأطباء، تتفوق على الأسئلة التشخيصية البالغة 13.9%، وهكذا تكون المساحة غير المقاسة هي الأوسع 613.
مالكو المحتوى المرخّص هم الفرصة الاستثمارية المتاحة
الأصول النادرة في الطب المبني على الأدلة اثنان: المحتوى المرخّص ومسار عمل الطبيب، وقد تحرك مالكوهما للتو في مواجهة تقييم الشركة غير المدرجة. والصراع الذي يستحق المراقبة يقع بين بند الإعلانات وبين الإجابات: فإذا بدأ مال شركات الأدوية داخل الأداة يشكّل ما يقرؤه الأطباء، فإن أولى العلامات ستظهر في الإفصاحات المرتبطة بتوقعات إيرادات إعلانات عام 2026 البالغة من 400 إلى 500 مليون دولار، التي يأتي اختبارها المقبل مع موسم تقارير نهاية العام، أو عندما يتحدى كادر طبي أو ناشر نموذج «الإعلانات والإجابات» أمام القضاء أو في دراسة 3.
وحتى ذلك الحين، يظل الرهان المالي على الانتشار، فيما باتت جودة الإجابات موثقة.
Get Health by email, free
AI in medicine, pharma and biotech. In our daily email, every weekday.