Las cartas de autorización previa de OpenEvidence no superan a las de ChatGPT en el test de la Mayo Clinic; los 15.000 millones de dólares compran su distribución
Un cara a cara liderado por la Mayo Clinic y un estudio de Nature Medicine ponen negro sobre blanco, en una sola semana, la calidad de las respuestas de OpenEvidence: lo bastante buenas para usarlas, ya no las únicas buenas. Con una valoración de 15.000 millones de dólares, los inversores pagan por la distribución, y la distribución ya no está sola.
 Vincent Jiang · 3 min read
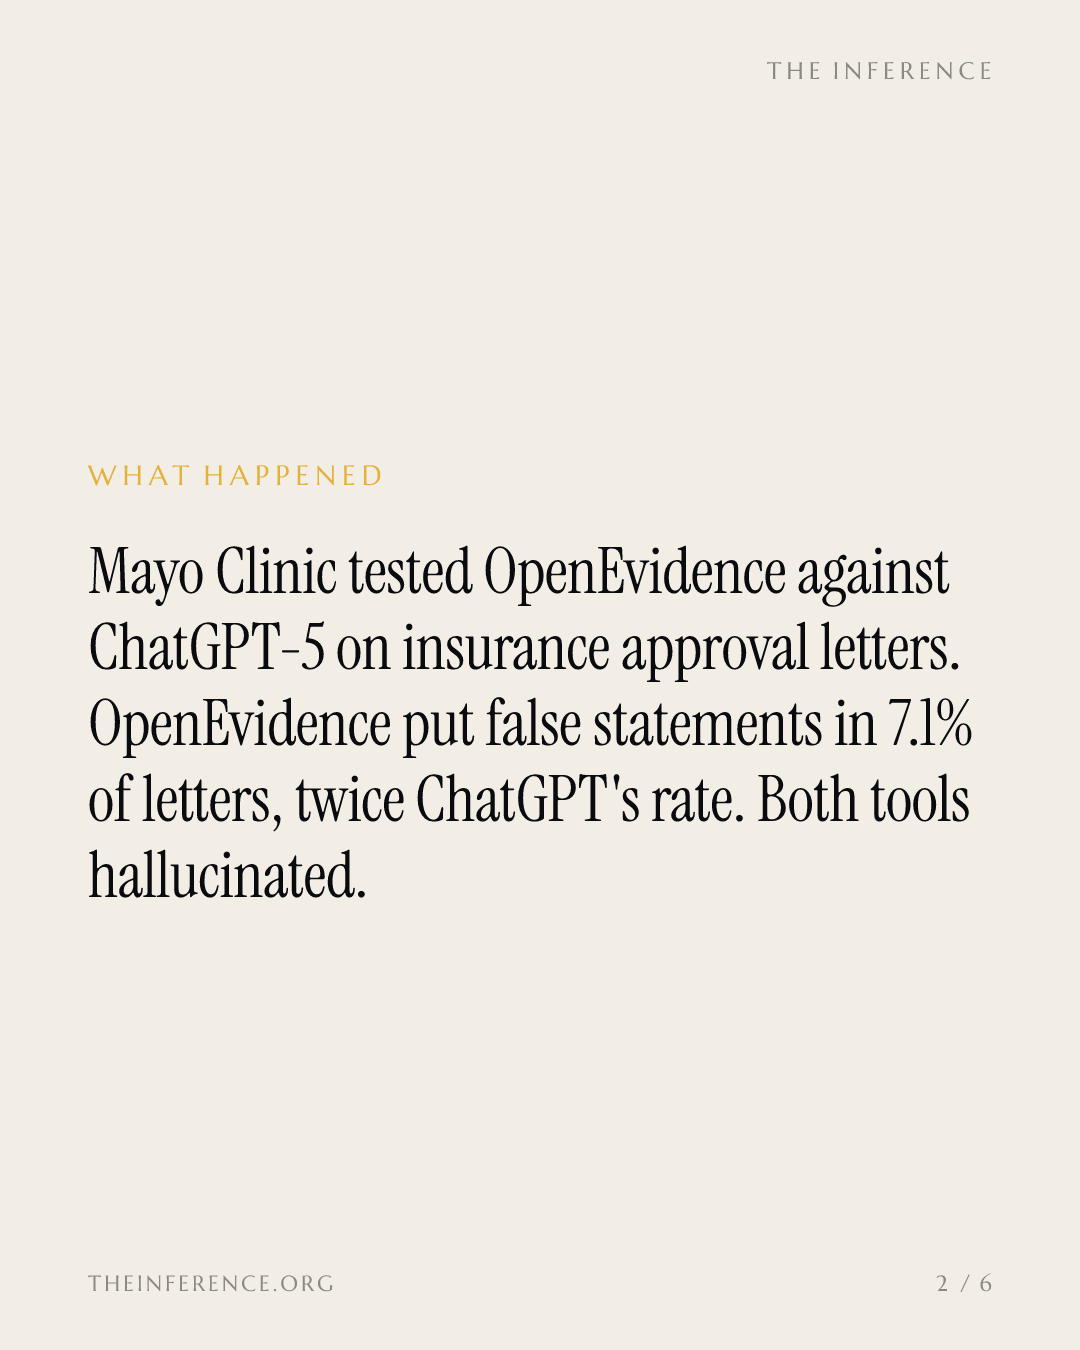
El documento más valioso de la medicina estadounidense es breve, poco vistoso y decide si una aseguradora cubre un medicamento: la carta de autorización previa. Un equipo liderado por la Mayo Clinic ha probado quién la redacta mejor, si OpenEvidence~$6B — OpenEvidence, private, latest valuation ~$6B o ChatGPT-5, en 28 escenarios de nefrología, esta semana en la ASN Kidney Week de Denver 1.
OpenEvidence, el motor de respuestas con IA que usan el 65 % de los médicos de EE UU, incluyó afirmaciones falsas en el 7,1 % de sus cartas, frente al 3,6 % de ChatGPT-5, y su razonamiento clínico se calificó de sólido en el 78,6 % de ellas, frente al 89,3 % 1. La codificación CIE-10 fue correcta en el 67,9 % de las cartas de OpenEvidence, frente al 78,6 % de ChatGPT-5, y los autores de la Mayo Clinic vincularon esa diferencia con la longitud: OpenEvidence redactó cartas más largas que a menudo superaban de sobra el objetivo de 350 palabras, y cuantas más palabras, más oportunidades de equivocarse 1.
OpenEvidence quedó por detrás de ChatGPT-5 en todos los indicadores de calidad de la carta, aunque en ninguno de forma significativa
- OpenEvidence
- ChatGPT-5
Data
| OpenEvidence | ChatGPT-5 | |
|---|---|---|
| Afirmaciones falsas | 7.1 | 3.6 |
| Razonamiento clínico sólido | 78.6 | 89.3 |
| Codificación CIE-10 correcta | 67.9 | 78.6 |
Ninguna diferencia alcanzó significación estadística, y la conclusión de los autores fue mesurada: son borradores para que los revise un clínico, no cartas terminadas. Ambas herramientas alucinaron 1.
Lo que está en juego: una denegación ganable que se abandona
Las aseguradoras de Medicare Advantage emitieron 52,8 millones de determinaciones de autorización previa en 2024, rechazaron 4,1 millones (el 7,7 %) y solo se recurrió el 11,5 % de las denegaciones 210. Cuando los clínicos recurrieron, el 80,7 % de esas denegaciones se revocó total o parcialmente 210. La denegación es ganable de forma rutinaria y de forma rutinaria se abandona, y ese es precisamente el flujo de trabajo al que se vende la redacción de cartas con IA 2.
La valoración compra distribución, y el historial de precisión ya lo confirma
OpenEvidence alcanzó en septiembre una valoración de 15.000 millones de dólares tras una ronda de 250 millones de dólares codirigida por Andreessen Horowitz y Byers Capital —su tercera revalorización del año—, sobre una proyección de entre 400 y 500 millones de dólares en ingresos publicitarios de farmacéuticas para 2026 3. Lo que compra ese dinero es distribución: 952.000 clínicos habían realizado 271 millones de consultas hasta junio de 2026, los usuarios activos mensuales alcanzaron los 703.265 y la plataforma gestionó 42 millones de prompts en octubre 311.
Lo que no compra, según el historial publicado, es el mejor modelo. En un estudio de Nature Medicine publicado en junio, OpenEvidence obtuvo un 89,6 % en 500 preguntas de MedQA, por debajo del 97,4 % de Gemini 3.1 Pro y del 94,2 % de GPT-5.2; los clínicos, en una evaluación a ciegas, la situaron al mismo nivel que UpToDate Expert AI y Google AI Overview 4.
En MedQA, OpenEvidence se quedó 7,8 puntos por detrás de Gemini 3.1 Pro
Data
| Value | |
|---|---|
| OpenEvidence | 89.6% |
| Claude Opus 4.6 | 90.2% |
| GPT-5.2 | 94.2% |
| Gemini 3.1 Pro | 97.4% |
El foso es la red, y esta semana sus bordes se han llenado de rivales
El Memorial Sloan Kettering está conectando su base de datos de genética tumoral OncoKB con OpenEvidence y con Epic 7. OneOncology, cuyos oncólogos comunitarios atienden a 1,5 millones de pacientes, ha incorporado la herramienta a sus flujos de trabajo 5.
Mientras tanto, Doximity−1.78% — Doximity, down 1.78 percent today, que llega a más del 85 % de los médicos de EE UU, cerró un acuerdo en la demanda que OpenEvidence le interpuso en junio de 2025: todas las pretensiones quedaron desestimadas con carácter definitivo el 17 de octubre y cada parte asumió sus propias costas 8912. En ese litigio, OpenEvidence alegó que empleados de Doximity se hicieron pasar por médicos y emplearon instrucciones de inyección de prompts (prompt injection) plantadas para engañar a la herramienta y lograr que revelara sus prompts de sistema confidenciales 89.
Dos días después del acuerdo, Doximity integró el UpToDate de Wolters Kluwer —13.000 temas revisados por expertos— en Ask, su herramienta rival, y la acción subió un 7,3 % 8912. La empresa propietaria del contenido con licencia juega ahora en los dos lados de la operación 8912.
El propio estudio de uso reconoce la pregunta abierta: cuenta quién pregunta, no si las respuestas son correctas ni si los pacientes evolucionan mejor. Las preguntas sobre tratamiento y manejo, el 33,1 % de las consultas de los médicos, superan a las de diagnóstico, con un 13,9 %, de modo que el terreno sin medir es el más amplio 613.
Los propietarios del contenido con licencia son la exposición invertible
Los activos escasos de la medicina basada en la evidencia son el contenido con licencia y el flujo de trabajo del médico, y los propietarios de ambos acaban de mover ficha contra la valoración de la compañía privada. El conflicto a vigilar está entre la línea de ingresos publicitarios y las respuestas: si el dinero de las farmacéuticas dentro de la herramienta empieza a condicionar lo que leen los médicos, las primeras señales vendrían de las revelaciones en torno a la previsión de entre 400 y 500 millones de dólares de ingresos publicitarios para 2026, cuya próxima prueba son los informes de fin de año, o de un clínico o una editorial que cuestione el modelo de publicidad y respuestas en los tribunales o en un estudio 3.
Hasta entonces, la apuesta es la distribución, y la calidad de las respuestas ya está documentada.
Get Health by email, free
AI in medicine, pharma and biotech. In our daily email, every weekday.