Chez la Mayo, OpenEvidence ne fait pas mieux que ChatGPT ; 15 milliards de dollars n'achètent que la distribution
En une semaine, un duel piloté par la clinique Mayo puis une étude parue dans Nature Medicine ont établi noir sur blanc la qualité des réponses d'OpenEvidence : suffisamment bonnes pour être utilisées, mais plus inégalées. À 15 milliards de dollars, les investisseurs paient la distribution — et la distribution, elle, a désormais de la compagnie.
 Vincent Jiang · 3 min read
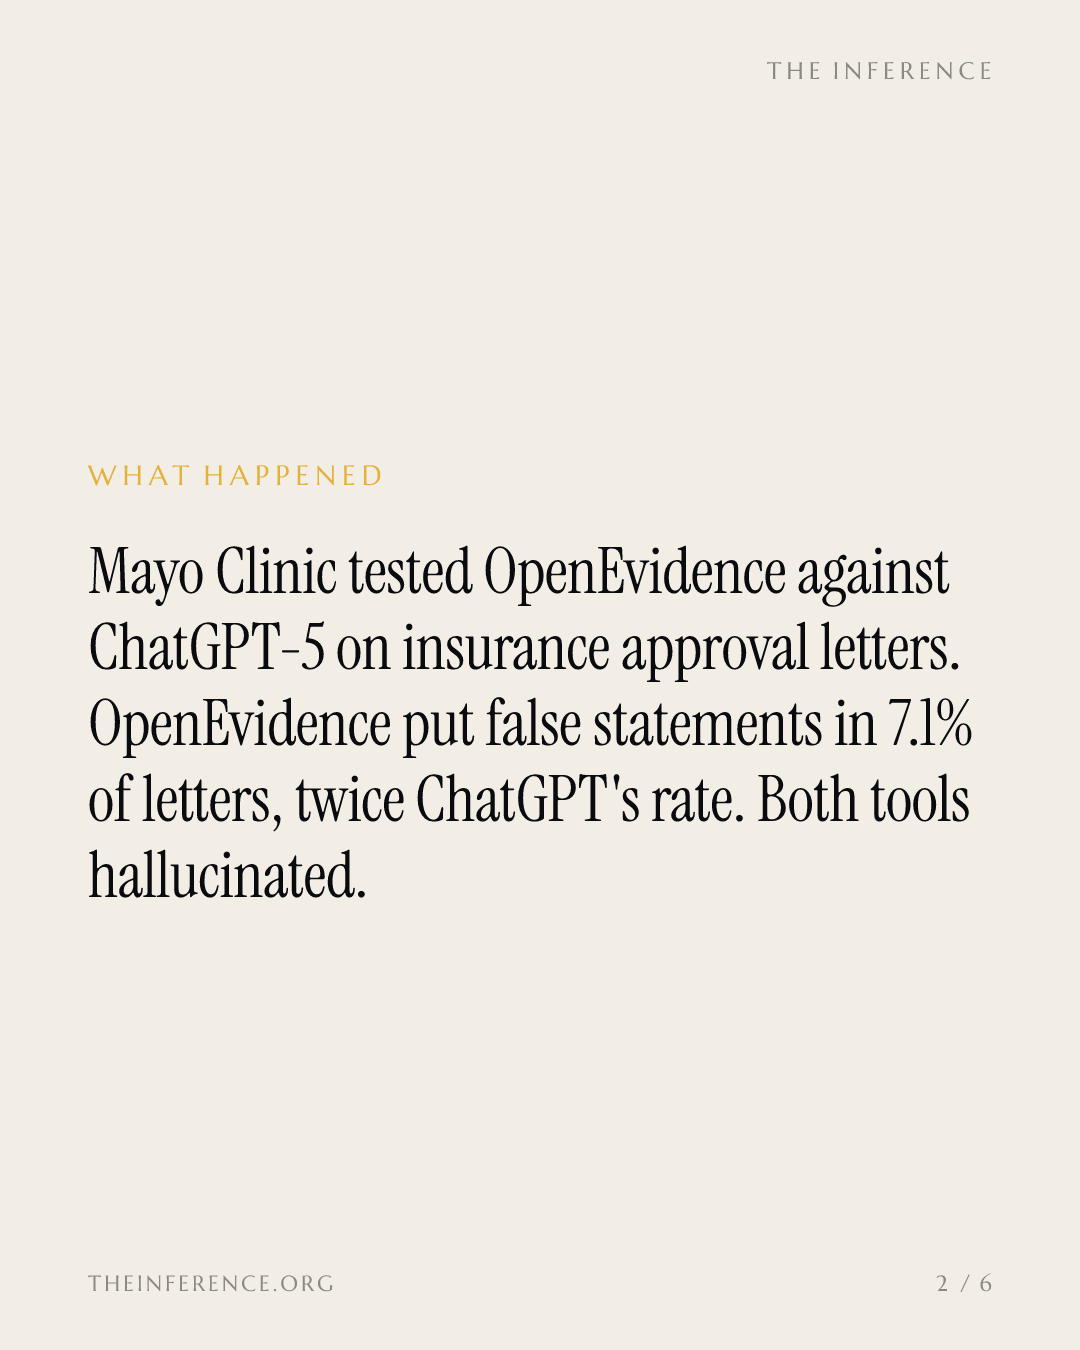
Le document le plus précieux de la médecine américaine est court, sans éclat, et décide si un assureur prend en charge un médicament : la lettre d'accord préalable (prior authorization letter). Une équipe pilotée par la clinique Mayo a testé qui la rédige le mieux, OpenEvidence~$6B — OpenEvidence, private, latest valuation ~$6B ou ChatGPT-5, sur 28 scénarios de néphrologie, cette semaine à l'ASN Kidney Week de Denver 1.
OpenEvidence, le moteur de réponses par IA qu'utilisent 65 % des médecins américains, a glissé des affirmations fausses dans 7,1 % de ses lettres, contre 3,6 % pour ChatGPT-5 ; son raisonnement clinique a été jugé solide dans 78,6 % des cas, contre 89,3 % 1. Le codage CIM-10 était exact dans 67,9 % des lettres d'OpenEvidence, contre 78,6 % pour ChatGPT-5 ; les auteurs de la Mayo relient cet écart à la longueur : OpenEvidence rédigeait des lettres plus longues, qui dépassaient souvent les 350 mots visés, et plus il y a de mots, plus il y a de risques d'erreur 1.
OpenEvidence devancé par ChatGPT-5 sur chaque critère de qualité des lettres, sans écart significatif
- OpenEvidence
- ChatGPT-5
Data
| OpenEvidence | ChatGPT-5 | |
|---|---|---|
| Affirmations fausses | 7.1 | 3.6 |
| Raisonnement clinique solide | 78.6 | 89.3 |
| Codage CIM-10 exact | 67.9 | 78.6 |
Aucun écart n'atteint la signification statistique, et la conclusion des auteurs se veut mesurée : ces lettres sont des brouillons à relire par un clinicien, pas des courriers définitifs. Les deux outils ont halluciné 1.
L'enjeu : un refus gagnable, et pourtant abandonné
Les assureurs Medicare Advantage ont rendu 52,8 millions de décisions d'accord préalable en 2024, dont 4,1 millions de refus (7,7 %), et seuls 11,5 % de ces refus ont donné lieu à un recours 210. Quand les cliniciens le faisaient, 80,7 % des refus étaient annulés, en tout ou en partie 210. Le refus est le plus souvent gagnable et le plus souvent abandonné : c'est très exactement dans ce circuit que l'on vend aujourd'hui la lettre rédigée par IA 2.
La valorisation achète la distribution, et le bilan de précision vient de le confirmer
OpenEvidence a atteint en septembre une valorisation de 15 milliards de dollars, à l'issue d'un tour de table de 250 millions de dollars mené conjointement par Andreessen Horowitz et Byers Capital (sa troisième revalorisation de l'année), sur la base d'un chiffre d'affaires publicitaire attendu de 400 à 500 millions de dollars en 2026 auprès des laboratoires pharmaceutiques 3. Ce que cet argent achète, c'est la distribution : en juin 2026, 952 000 cliniciens avaient soumis 271 millions de requêtes ; les utilisateurs actifs mensuels ont atteint 703 265, et la plateforme a traité 42 millions de prompts en octobre 311.
Ce qu'il n'achète pas, en revanche, au vu des études publiées, c'est le meilleur modèle. Dans une étude parue en juin dans Nature Medicine, OpenEvidence a obtenu 89,6 % sur 500 questions MedQA, derrière Gemini 3.1 Pro (97,4 %) et GPT-5.2 (94,2 %) ; des cliniciens, en aveugle, l'ont jugé au même niveau qu'UpToDate Expert AI et que Google AI Overview 4.
Sur MedQA, OpenEvidence accusait 7,8 points de retard sur Gemini 3.1 Pro
Data
| Value | |
|---|---|
| OpenEvidence | 89.6% |
| Claude Opus 4.6 | 90.2% |
| GPT-5.2 | 94.2% |
| Gemini 3.1 Pro | 97.4% |
Le rempart, c'est le réseau — et ses abords se sont encombrés cette semaine
Le Memorial Sloan Kettering connecte sa base de données de génétique tumorale OncoKB à OpenEvidence et à Epic 7. OneOncology, dont les oncologues de ville prennent en charge 1,5 million de patients, a intégré l'outil à ses circuits cliniques 5.
De son côté, Doximity−1.78% — Doximity, down 1.78 percent today, qui touche plus de 85 % des médecins américains, a réglé à l'amiable le procès que OpenEvidence lui avait intenté en juin 2025, toutes les demandes ayant été définitivement closes le 17 octobre, chaque partie supportant ses propres frais 8912. Dans ce litige, OpenEvidence soutenait que des employés de Doximity s'étaient fait passer pour des médecins et avaient utilisé des instructions d'injection de prompt dissimulées pour pousser l'outil à divulguer ses prompts système confidentiels 89.
Deux jours après ce règlement, Doximity a intégré dans Ask, son outil rival, UpToDate de Wolters Kluwer et ses 13 000 thèmes validés par des experts : le titre a gagné 7,3 % 8912. La société qui possède ces contenus sous licence se retrouve désormais des deux côtés de l'échiquier 8912.
L'étude d'usage elle-même concède que la question reste ouverte : elle compte qui interroge l'outil, pas si les réponses sont exactes ni si les patients s'en portent mieux. Les questions de traitement et de prise en charge, qui représentent 33,1 % des requêtes des médecins, devancent les questions de diagnostic, à 13,9 % — si bien que la zone la plus vaste est précisément celle qui reste non mesurée 613.
Les détenteurs de contenus sous licence, l'exposition investissable
Les actifs rares de la médecine fondée sur les preuves, ce sont les contenus sous licence et le circuit du médecin — et les détenteurs des deux viennent de manœuvrer contre la valorisation privée. Le conflit à surveiller se niche entre la ligne publicitaire et les réponses : si l'argent des laboratoires commence, au sein de l'outil, à façonner ce que lisent les médecins, les premiers signes viendraient des informations divulguées sur la prévision de chiffre d'affaires publicitaire de 400 à 500 millions de dollars pour 2026, dont le prochain test est la saison des publications de fin d'année, ou d'un clinicien ou d'un éditeur qui contesterait le modèle alliant publicité et réponses devant les tribunaux ou dans une étude 3.
D'ici là, l'argent mise sur la distribution, et la qualité des réponses est désormais documentée.
Get Health by email, free
AI in medicine, pharma and biotech. In our daily email, every weekday.