मेयो क्लिनिक टेस्ट में OpenEvidence की प्राइर ऑथराइजेशन लेटर ChatGPT से बेहतर नहीं; 15 अरब डॉलर में खरीदा जा रहा है डिस्ट्रीब्यूशन
एक ही हफ्ते में मेयो क्लिनिक के एक हेड-टू-हेड टेस्ट और Nature Medicine की एक स्टडी ने OpenEvidence के जवाबों की क्वालिटी का रिकॉर्ड सामने रख दिया है — इस्तेमाल लायक हां, पर अब बेमिसाल नहीं। 15 अरब डॉलर की वैल्यूएशन पर निवेशक दरअसल डिस्ट्रीब्यूशन के लिए पैसा लगा रहे हैं, और डिस्ट्रीब्यूशन के मैदान में अब वह अकेली नहीं है।
 Vincent Jiang · 3 min read
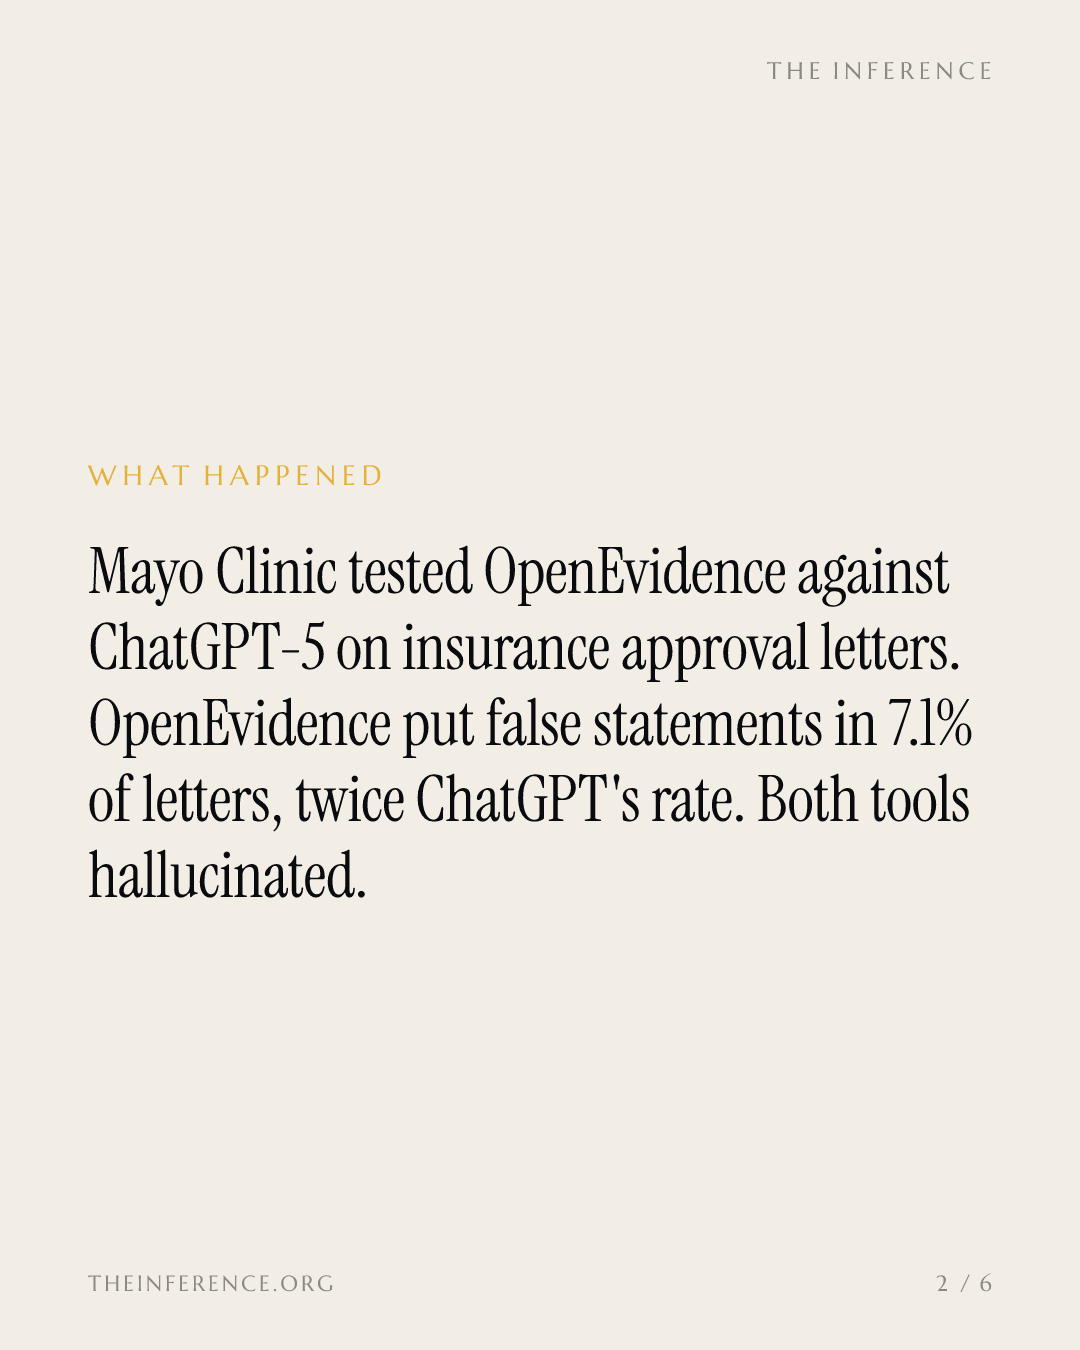
अमेरिकी चिकित्सा जगत का सबसे कीमती दस्तावेज़ छोटा-सा और दिखने में बेजान है, लेकिन यही तय करता है कि बीमा कंपनी किसी दवा का भुगतान करेगी या नहीं — प्राइर ऑथराइजेशन (पूर्व-अनुमति) का पत्र। मेयो क्लिनिक की अगुवाई वाली टीम ने इस हफ्ते डेनवर में ASN किडनी वीक के दौरान नेफ्रोलॉजी (गुर्दा रोग विज्ञान) से जुड़े 28 परिदृश्यों पर जांच की कि यह पत्र कौन बेहतर लिखता है — OpenEvidence~$6B — OpenEvidence, private, latest valuation ~$6B या ChatGPT-5 1।
OpenEvidence वह AI आंसर इंजन (सवालों के जवाब देने वाला टूल) है, जिसका इस्तेमाल अमेरिकी डॉक्टरों में से 65% करते हैं। टेस्ट में इसके पत्रों के 7.1% में गलत बयान मिले; ChatGPT-5 के पत्रों में यह दर 3.6% रही। क्लिनिकल रीजनिंग (चिकित्सकीय तर्क) OpenEvidence के 78.6% पत्रों में मजबूत आंकी गई, जबकि ChatGPT-5 के हिस्से 89.3% आए 1। ICD-10 (रोग वर्गीकरण कोड) की कोडिंग OpenEvidence के 67.9% पत्रों में सही थी, ChatGPT-5 में यह आंकड़ा 78.6% रहा। मेयो के शोधकर्ताओं ने यह गैप पत्रों की लंबाई से जोड़ा: OpenEvidence के पत्र लंबे थे और अक्सर 350 शब्दों के लक्ष्य को पीछे छोड़ जाते थे — और शब्द जितने ज्यादा, गलती के मौके उतने ही ज्यादा 1।
पत्र की क्वालिटी के हर पैमाने पर OpenEvidence ChatGPT-5 से पीछे रहा — पर किसी पर भी बड़ा फर्क नहीं
- OpenEvidence
- ChatGPT-5
Data
| OpenEvidence | ChatGPT-5 | |
|---|---|---|
| गलत बयान | 7.1 | 3.6 |
| मजबूत क्लिनिकल रीजनिंग | 78.6 | 89.3 |
| सही ICD-10 कोडिंग | 67.9 | 78.6 |
कोई भी अंतर सांख्यिकीय रूप से महत्वपूर्ण नहीं था, और स्टडी के लेखकों का निष्कर्ष संयत था: ये डॉक्टर की समीक्षा के लिए ड्राफ्ट हैं, भेजने को तैयार चिट्ठियां नहीं। और दोनों टूल्स ने हैल्यूसिनेशन (बनावटी जानकारी गढ़ना) भी किया 1।
असली दांव: वह इनकार जो लड़ा जा सकता है, पर छोड़ दिया जाता है
मेडिकेयर एडवांटेज (अमेरिकी सरकारी सहायता वाली निजी बीमा योजना) चलाने वाली कंपनियों ने 2024 में 5.28 करोड़ प्राइर ऑथराइजेशन फैसले लिए। इनमें से 41 लाख (7.7%) मांगें ठुकराई गईं, और इनकारों में से सिर्फ 11.5% के खिलाफ अपील हुई 210। जहां डॉक्टरों ने अपील की, वहां 80.7% इनकार पूरी तरह या आंशिक रूप से पलट गए 210। यानी यह इनकार आम तौर पर जीता जा सकता है और आम तौर पर छोड़ दिया जाता है — और एआई से पत्र लिखवाने का जो कारोबार है, वह ठीक इसी वर्कफ्लो (काम करने की प्रक्रिया) में बेचा जा रहा है 2।
वैल्यूएशन डिस्ट्रीब्यूशन खरीदती है — और सटीकता का रिकॉर्ड अब यही कहता है
सितंबर में, एंड्रीसन होरोविट्ज़ (Andreessen Horowitz) और Byers Capital की सह-अगुवाई में हुए 25 करोड़ डॉलर के फंडिंग राउंड के बाद OpenEvidence का वैल्यूएशन 15 अरब डॉलर पर पहुंच गया — इस साल वैल्यूएशन में यह तीसरा इजाफा है। यह कीमत इस अनुमान पर टिकी है कि फार्मा कंपनियों के विज्ञापनों से कंपनी को 2026 में 40 से 50 करोड़ डॉलर की आमद होगी 3। और यह पैसा डिस्ट्रीब्यूशन खरीदता है: जून 2026 तक 9.52 लाख डॉक्टरों ने 27.1 करोड़ क्वेरी दर्ज की थीं, मंथली एक्टिव यूजर्स 7,03,265 पर पहुंच गए और अक्टूबर में प्लेटफॉर्म ने 4.2 करोड़ प्रॉम्प्ट प्रोसेस किए 311।
लेकिन प्रकाशित रिकॉर्ड के हिसाब से यह पैसा सबसे बेहतर मॉडल नहीं खरीदता। जून में छपी एक Nature Medicine स्टडी में OpenEvidence ने 500 MedQA प्रश्नों पर 89.6% स्कोर किया, जबकि Gemini 3.1 Pro 97.4% और GPT-5.2 94.2% पर रहे। ब्लाइंड रेटिंग (टूल के नाम छिपाकर) में डॉक्टरों ने इसे UpToDate Expert AI और गूगल AI Overview के बराबर आंका 4।
MedQA पर OpenEvidence रहा Gemini 3.1 Pro से 7.8 अंक पीछे
Data
| Value | |
|---|---|
| OpenEvidence | 89.6% |
| Claude Opus 4.6 | 90.2% |
| GPT-5.2 | 94.2% |
| Gemini 3.1 Pro | 97.4% |
असली खाई नेटवर्क है — और इस हफ्ते उसके किनारों पर भीड़ जुट गई
मेमोरियल स्लोअन केटरिंग अपना OncoKB ट्यूमर-जेनेटिक्स डेटाबेस OpenEvidence और Epic से जोड़ रहा है 7। OneOncology — जिसके कम्युनिटी ऑन्कोलॉजिस्ट 15 लाख मरीजों का इलाज करते हैं — ने टूल को अपने वर्कफ्लो में शामिल कर लिया है 5।
इसी बीच Doximity−1.78% — Doximity, down 1.78 percent today — जो अमेरिकी डॉक्टरों के 85% से ज्यादा तक पहुंच रखता है — ने वह मुकदमा सुलझा लिया जो OpenEvidence ने जून 2025 में उस पर दायर किया था। 17 अक्टूबर को सभी दावे 'विद प्रिज्यूडिस' की हालत में खारिज हुए — यानी दोबारा दायर नहीं किए जा सकते — और हर पक्ष अपना खर्च खुद उठाएगा 8912। उस मुकदमे में OpenEvidence का आरोप था कि Doximity के कर्मचारी डॉक्टर बनकर घुसे थे और छिपाकर डाले गए प्रॉम्प्ट-इंजेक्शन (prompt injection) निर्देशों की मदद से टूल को धोखा देकर उसके गोपनीय सिस्टम प्रॉम्प्ट उगलवा लिए थे 89।
इस समझौते के ठीक दो दिन बाद Doximity ने वॉल्टर्स क्लूवर (Wolters Kluwer) का UpToDate — जिसमें 13,000 विषयों की विशेषज्ञ-समीक्षा शामिल है — अपने उस Ask टूल में जोड़ दिया, जो OpenEvidence को मुकाबला देता है। कंपनी का शेयर 7.3% चढ़ गया 8912। लाइसेंस्ड कंटेंट (licensed content) जिस कंपनी के पास है, वह अब इस सौदे के दोनों तरफ मौजूद है 8912।
उपयोग पर बनी यह स्टडी खुद एक खुला सवाल कबूल करती है: वह गिनती सिर्फ इस बात की करती है कि कौन पूछ रहा है — यह नहीं कि जवाब सही हैं या नहीं, और यह भी नहीं कि मरीजों का हाल बेहतर हुआ या नहीं। डॉक्टरों की क्वेरी में इलाज और प्रबंधन से जुड़े सवाल 33.1% हैं, जबकि निदान संबंधी सवाल सिर्फ 13.9%। यानी जिस हिस्से को नापा नहीं गया, वही हिस्सा सबसे बड़ा है 613।
निवेश का दांव: लाइसेंस्ड कंटेंट के मालिक
एविडेंस-बेस्ड मेडिसिन (सबूतों पर आधारित चिकित्सा) में दुर्लभ एसेट दो ही हैं — लाइसेंस्ड कंटेंट और डॉक्टरों का वर्कफ्लो। दोनों के मालिकों ने अभी-अभी इस निजी वैल्यूएशन के खिलाफ चाल चल दी है। नजर रखने लायक टकराव विज्ञापन आय की लाइन और जवाबों के बीच खड़ा है: अगर टूल के अंदर का फार्मा पैसा यह तय करने लगे कि डॉक्टर क्या पढ़ें, तो पहले संकेत दो जगहों से आएंगे। एक, 2026 के 40-50 करोड़ डॉलर के विज्ञापन-राजस्व अनुमान को लेकर होने वाले डिस्क्लोजर — जिनकी अगली परीक्षा साल के आखिर की रिपोर्टिंग सीज़न है। दूसरी, अदालत या किसी स्टडी में विज्ञापन-और-जवाब वाले मॉडल को चुनौती देने वाला कोई डॉक्टर या प्रकाशक 3।
तब तक पैसा डिस्ट्रीब्यूशन पर ही लगा है — और जवाबों की क्वालिटी अब रिकॉर्ड पर दर्ज हो चुकी है।
Get Health by email, free
AI in medicine, pharma and biotech. In our daily email, every weekday.