OpenEvidenceの事前承認レター、メイヨー試験でChatGPT-5に及ばず 150億ドルの評価額が買うのは普及網
メイヨー・クリニック主導の直接対決試験と英医学誌ネイチャー・メディシン(Nature Medicine)の研究が、1週間のうちにOpenEvidenceの回答の質を記録に残した。使える水準ではあるが、もはや唯一無二ではない。評価額150億ドルで投資家が買っているのは普及網であり、その普及網は今や独りではなくなった。
 Vincent Jiang · 3 min read
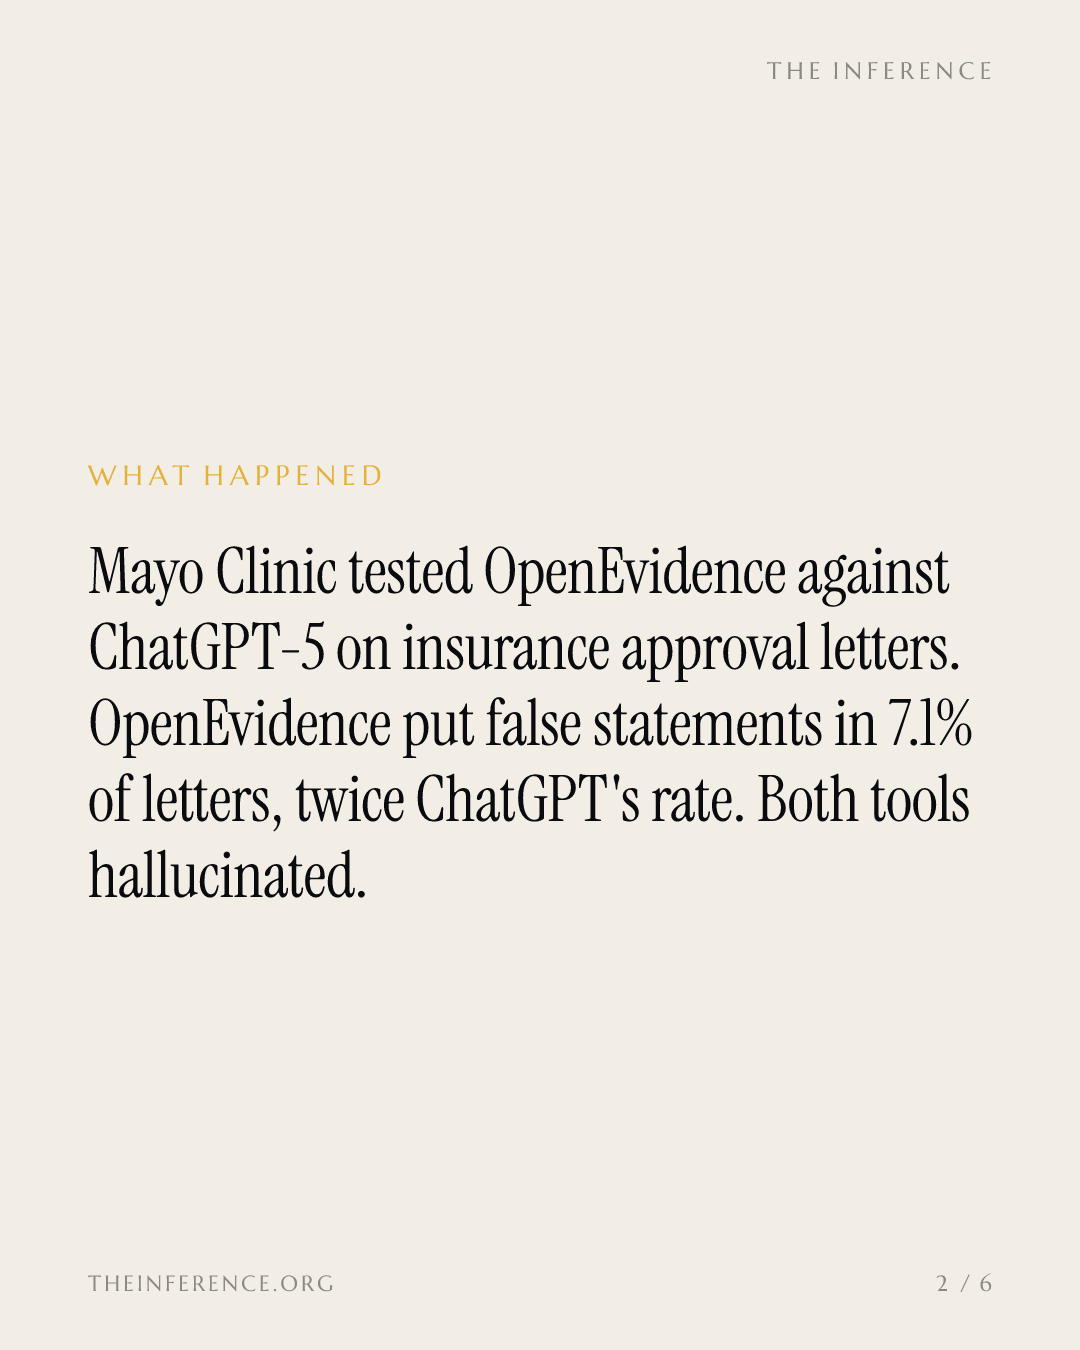
米国医療で最も価値のある文書は、短く、地味で、保険者が薬剤の費用を払うかどうかを左右する。それが事前承認(prior authorization)レターだ。メイヨー・クリニック主導のチームは、OpenEvidence~$6B — OpenEvidence, private, latest valuation ~$6BとChatGPT-5のどちらがこのレターをうまく書けるかを、腎臓領域の28のシナリオで試した。今週デンバーで開かれた米国腎臓学会(ASN)の年次集会「ASN Kidney Week」での発表である1。
米国の医師の65%が使うAI回答エンジン、OpenEvidenceは、作成したレターの7.1%に誤った記述を含んだのに対し、ChatGPT-5は3.6%だった。臨床推論が「強い」と評価されたのは、OpenEvidenceが78.6%、ChatGPT-5が89.3%だった1。ICD-10(国際疾病分類)によるコーディングの正確さでは、OpenEvidenceが67.9%、ChatGPT-5が78.6%。メイヨーの著者らはこの差を長さに結びつけた。OpenEvidenceのレターは長くなりがちで、目標の350語をしばしば大幅に超えた。言葉数が増えれば、誤りが入り込む機会も増える1。
レター品質の全指標でOpenEvidenceがChatGPT-5を下回る、ただしいずれも有意差なし
- OpenEvidence
- ChatGPT-5
Data
| OpenEvidence | ChatGPT-5 | |
|---|---|---|
| 誤った記述 | 7.1 | 3.6 |
| 臨床推論が強い | 78.6 | 89.3 |
| ICD-10コードが正確 | 67.9 | 78.6 |
差はいずれも統計的有意には達せず、著者らの結論も控えめだった。これらは医療従事者が確認すべき草稿であって、完成したレターではない、という位置づけだ。両ツールともハルシネーション(幻覚)を起こした1。
勝てるはずの不承認が、見捨てられる
米高齢者向け公的医療保険メディケアの民間プラン、メディケア・アドバンテージ(Medicare Advantage)の保険者は2024年、事前承認の判定を5280万件行い、うち410万件(7.7%)を不承認とした。不承認について不服申立てがなされたのは11.5%にとどまった210。実際に申立てた場合、80.7%が全部または一部で覆されている210。不承認はたいてい勝てる。そしてたいてい見捨てられる。AIによるレター作成が売り込まれているのは、まさにこの業務プロセスだ2。
評価額が買うのは普及網、精度の記録もそれを裏付ける
OpenEvidenceは9月、アンドリーセン・ホロウィッツ(Andreessen Horowitz)とバイヤーズ・キャピタル(Byers Capital)が共同で率いる2億5000万ドルの資金調達を終え、評価額は150億ドルに達した。今年に入って3回目の評価額引き上げで、製薬会社からの2026年の広告収入が4億~5億ドルになるという予測が下支えしている3。この資金が買うのは普及網だ。2026年6月までに95万2000人の医療従事者が2億7100万件の質問を投じ、月間アクティブユーザーは70万3265人に達した。10月にはプラットフォームで4200万件のプロンプトを処理した311。
公表された記録が語る限り、この資金が買っていないのは最高のモデルだ。6月の英医学誌ネイチャー・メディシンの研究では、OpenEvidenceは医学試験問題データセット「MedQA」500問で89.6%の正答率にとどまり、97.4%のGemini 3.1 Proや94.2%のGPT-5.2をいずれも下回った。対象を伏せて評価した医師らの判定では、UpToDate Expert AIやグーグルのAI Overviewと同等とされた4。
MedQAでOpenEvidenceはGemini 3.1 Proに7.8ポイント及ばず
Data
| Value | |
|---|---|
| OpenEvidence | 89.6% |
| Claude Opus 4.6 | 90.2% |
| GPT-5.2 | 94.2% |
| Gemini 3.1 Pro | 97.4% |
堀はネットワーク、だが今週その縁に競合が集まった
メモリアル・スローン・ケタリングは、自社の腫瘍遺伝子データベースOncoKBをOpenEvidenceと電子カルテ大手のエピック(Epic)へ組み込みつつある7。地域で診療する腫瘍医が患者150万人を担当するOneOncologyは、同ツールを診療ワークフローに組み込んだ5。
その一方で、米国の医師の85%超をカバーするDoximity−1.78% — Doximity, down 1.78 percent todayは、OpenEvidenceが2025年6月に提起した訴訟で和解が成立した。10月17日、全請求が再提起不可の形で棄却され、訴訟費用は双方がそれぞれ負担する8912。この訴訟でOpenEvidenceは、Doximityの従業員が医師を装い、仕込んだプロンプト・インジェクション(prompt injection)の指示で同ツールから機密のシステムプロンプトを引き出させた、と主張していた89。
和解から2日後、Doximityはウォルターズ・クルワー(Wolters Kluwer)のUpToDateを、OpenEvidenceと競合する自社ツール「Ask」に組み込んだ。専門家がレビューした1万3000のトピックを擁するコンテンツだ。これを受け、Doximityの株価は7.3%上昇した8912。ライセンスコンテンツの所有者は、今やこの勝負の両側に座る格好だ8912。
この利用実態調査自体も、答えの出ていない問いを認めている。数えているのは誰が質問したかで、回答が正しいのか、患者の転帰が良くなるのかは見ていない。医師の質問に占める治療・管理関連は33.1%で、診断関連の13.9%を上回る。つまり、測られていない領域こそが最も広いのだ613。
投資対象はライセンスコンテンツの持ち主
エビデンスに基づく医療(EBM)で希少な資産は、ライセンスコンテンツと医師の診療ワークフローだ。その両方の持ち主がこのほど、非上場企業の評価額に立ちはだかる動きを見せた。注視すべき対立は、広告収入と回答のあいだにある。ツール内に流れる製薬マネーが医師の目にする内容を作り変え始めれば、最初の兆候は2026年の広告収入4億~5億ドルという見通しをめぐる開示か、医療者や出版社が「広告と回答」モデルを裁判や研究で追及する動きとして表れるはずだ。この見通しの次の検証の場は、年末の決算・開示シーズンとなる3。
それまでの間、マネーが賭けるのは普及網だ。そしていまや記録に残ったのは、回答の質である。
Get Health by email, free
AI in medicine, pharma and biotech. In our daily email, every weekday.