Cartas de autorização prévia da OpenEvidence não são melhores que as do ChatGPT em teste da Mayo Clinic; US$ 15 bilhões pagam pela distribuição
Em uma semana, um duelo liderado pela Mayo Clinic e um estudo na revista Nature Medicine deixaram registrada a qualidade das respostas da OpenEvidence: boas o suficiente para usar, mas já não as únicas boas. Com avaliação de US$ 15 bilhões, os investidores pagam pela distribuição — e a distribuição agora tem companhia.
 Vincent Jiang · 3 min read
O documento mais valioso da medicina americana é curto, sem glamour e decide se uma operadora de saúde vai pagar por um medicamento: a carta de autorização prévia. Nesta semana, no congresso ASN Kidney Week, em Denver, uma equipe liderada pela Mayo Clinic testou quem a redige melhor, a OpenEvidence~$6B — OpenEvidence, private, latest valuation ~$6B ou o ChatGPT-5, em 28 cenários de nefrologia 1.
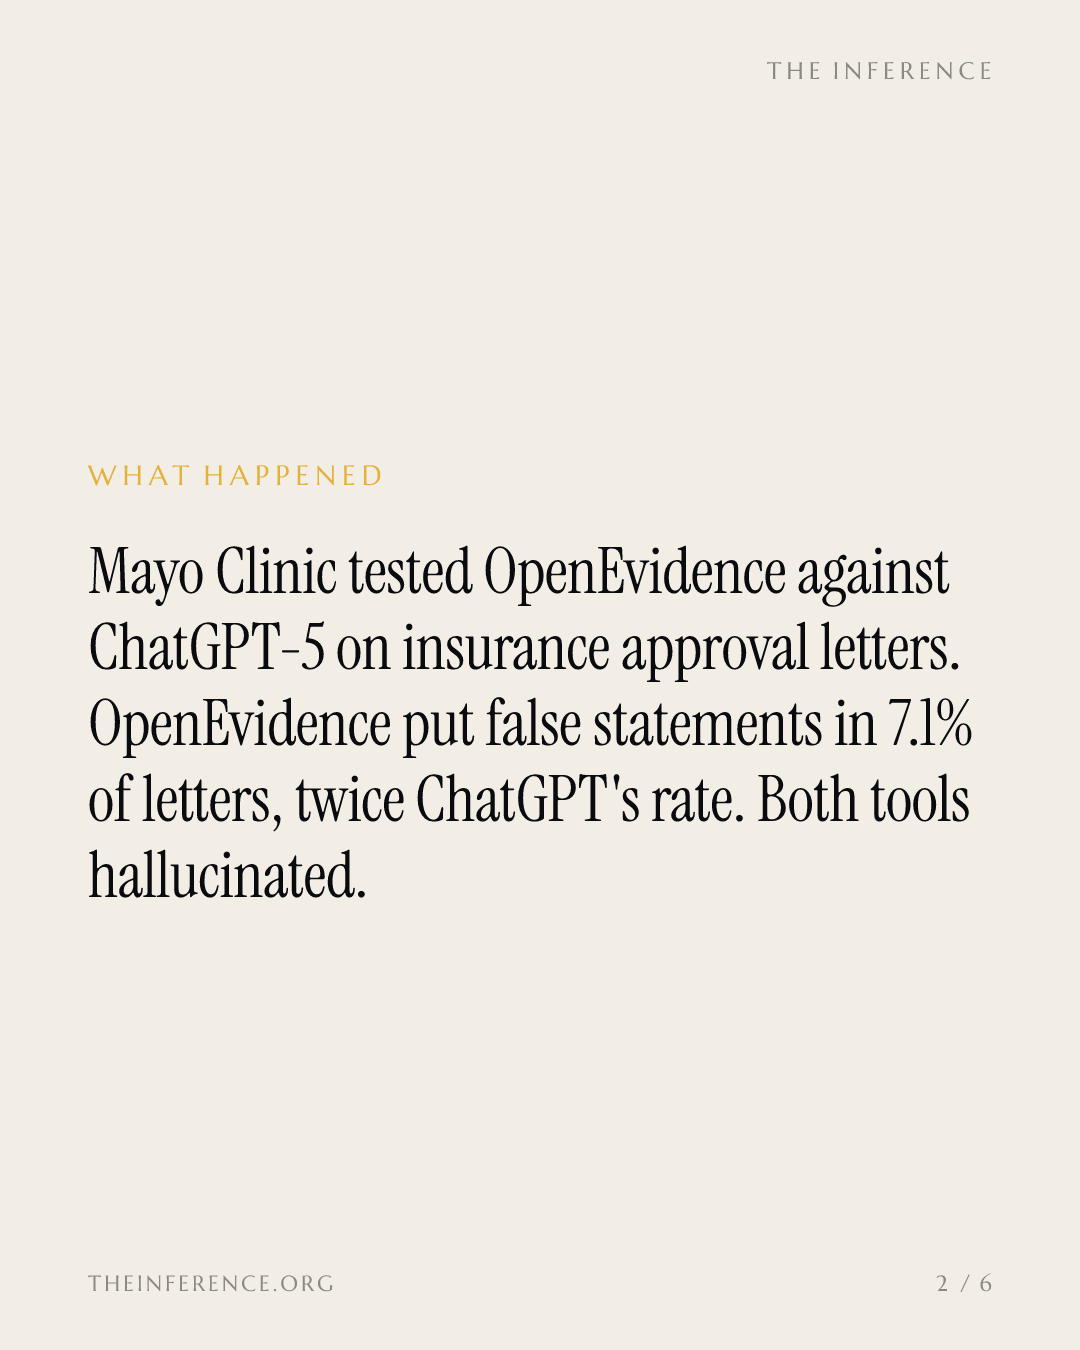
A OpenEvidence, motor de respostas com IA usado por 65% dos médicos americanos, incluiu afirmações falsas em 7,1% de suas cartas, contra 3,6% do ChatGPT-5; o raciocínio clínico foi avaliado como forte em 78,6% delas, contra 89,3% 1. A codificação CID-10 estava correta em 67,9% das cartas da OpenEvidence, contra 78,6% do ChatGPT-5. Os autores da Mayo atrelaram essa diferença ao tamanho das cartas: a OpenEvidence escreveu textos mais longos, que frequentemente estouravam a meta de 350 palavras — e mais palavras significam mais chances de errar 1.
OpenEvidence ficou atrás do ChatGPT-5 em todos os critérios de qualidade das cartas — nenhuma diferença foi significativa
- OpenEvidence
- ChatGPT-5
Data
| OpenEvidence | ChatGPT-5 | |
|---|---|---|
| Afirmações falsas | 7.1 | 3.6 |
| Raciocínio clínico forte | 78.6 | 89.3 |
| Codificação CID-10 correta | 67.9 | 78.6 |
Nenhuma diferença alcançou significância estatística, e a conclusão dos autores foi comedida: são rascunhos para um profissional de saúde revisar, não cartas prontas. As duas ferramentas alucinaram 1.
O que está em jogo: uma negativa reversível — e rotineiramente abandonada
As operadoras do Medicare Advantage fizeram 52,8 milhões de decisões de autorização prévia em 2024, negaram 4,1 milhões (7,7%) — e apenas 11,5% das negativas receberam recurso 210. Quando os profissionais de saúde recorriam, 80,7% das negativas eram total ou parcialmente revertidas 210. A negativa é rotineiramente reversível e rotineiramente abandonada, e é justamente nesse fluxo de trabalho que a redação de cartas por IA está sendo vendida 2.
A avaliação compra distribuição, e o histórico de acurácia agora confirma isso
A OpenEvidence chegou aos US$ 15 bilhões em setembro, depois de uma rodada de US$ 250 milhões liderada em conjunto pela Andreessen Horowitz e pela Byers Capital. Foi sua terceira alta de avaliação neste ano, com base em uma receita publicitária projetada de US$ 400 milhões a US$ 500 milhões em 2026, vinda de empresas farmacêuticas 3. O que o dinheiro compra é distribuição: 952 mil profissionais de saúde haviam feito 271 milhões de consultas até junho de 2026, os usuários ativos mensais chegaram a 703.265 e a plataforma processou 42 milhões de prompts em outubro 311.
O que o dinheiro não compra, à luz do que está publicado, é o melhor modelo. Em um estudo de junho na revista Nature Medicine, a OpenEvidence obteve 89,6% em 500 perguntas do MedQA — abaixo dos 97,4% do Gemini 3.1 Pro e dos 94,2% do GPT-5.2. Em avaliação cega, profissionais de saúde colocaram a ferramenta em pé de igualdade com o UpToDate Expert AI e o Google AI Overview 4.
No MedQA, a OpenEvidence ficou 7,8 pontos atrás do Gemini 3.1 Pro
Data
| Value | |
|---|---|
| OpenEvidence | 89.6% |
| Claude Opus 4.6 | 90.2% |
| GPT-5.2 | 94.2% |
| Gemini 3.1 Pro | 97.4% |
O fosso é a rede, e nesta semana suas margens ficaram disputadas
O Memorial Sloan Kettering está integrando sua base de dados de genética tumoral OncoKB à OpenEvidence e ao Epic 7. A OneOncology, cujos oncologistas comunitários atendem 1,5 milhão de pacientes, incorporou a ferramenta a seus fluxos de trabalho 5.
Enquanto isso, a Doximity−1.78% — Doximity, down 1.78 percent today, que alcança mais de 85% dos médicos americanos, fechou um acordo para encerrar a ação que a OpenEvidence moveu contra a empresa em junho de 2025: todas as alegações foram arquivadas em caráter definitivo em 17 de outubro, com cada parte arcando com as próprias custas 8912. Na ação, a OpenEvidence alegou que funcionários da Doximity se passaram por médicos e usaram instruções plantadas de injeção de prompt (prompt injection) para ludibriar a ferramenta e fazê-la revelar seus prompts de sistema confidenciais 89.
Dois dias após o acordo, a Doximity embutiu em sua ferramenta rival, a Ask, o UpToDate, da Wolters Kluwer — 13 mil temas revisados por especialistas —, e a ação subiu 7,3% 8912. A empresa que detém o conteúdo licenciado agora está dos dois lados da operação 8912.
O próprio estudo de uso admite a questão em aberto: ele contabiliza quem pergunta, não se as respostas estão certas ou se os pacientes evoluem melhor. Perguntas sobre tratamento e manejo, que respondem por 33,1% das consultas dos médicos, superam as diagnósticas, com 13,9% — logo, a área não medida é a mais ampla 613.
Os donos do conteúdo licenciado são a exposição investível
Os ativos escassos na medicina baseada em evidências são o conteúdo licenciado e o fluxo de trabalho do médico — e os donos de ambos acabaram de agir contra a avaliação privada. O conflito a acompanhar está entre a linha publicitária e as respostas: se o dinheiro das empresas farmacêuticas dentro da ferramenta começar a moldar o que os médicos leem, os primeiros sinais viriam das divulgações sobre a projeção de receita publicitária de US$ 400 milhões a US$ 500 milhões para 2026 — cujo próximo teste é a temporada de balanços de fim de ano — ou de um profissional de saúde ou de uma editora que desafie o modelo de anúncios e respostas na Justiça ou em um estudo 3.
Até lá, o dinheiro está na distribuição, e a qualidade das respostas agora está documentada.
Get Health by email, free
AI in medicine, pharma and biotech. In our daily email, every weekday.