Письма OpenEvidence о предварительном согласовании не лучше, чем у ChatGPT, показал тест клиники Мэйо; $15 млрд — плата за дистрибуцию
Сравнительное испытание под руководством клиники Мэйо и исследование в Nature Medicine за одну неделю официально зафиксировали качество ответов OpenEvidence: достаточно хорошее, чтобы пользоваться, но уже не уникальное. При оценке $15 млрд инвесторы платят за дистрибуцию — и теперь она не одна.
 Vincent Jiang · 3 min read
Самый ценный документ в американской медицине короткий, неброский и решает, оплатит ли страховщик препарат, — это письмо о предварительном согласовании (prior authorization letter). На этой неделе на конференции ASN Kidney Week в Денвере команда под руководством клиники Мэйо проверила, кто пишет их лучше — OpenEvidence~$6B — OpenEvidence, private, latest valuation ~$6B или ChatGPT-5 — на 28 нефрологических сценариях 1.
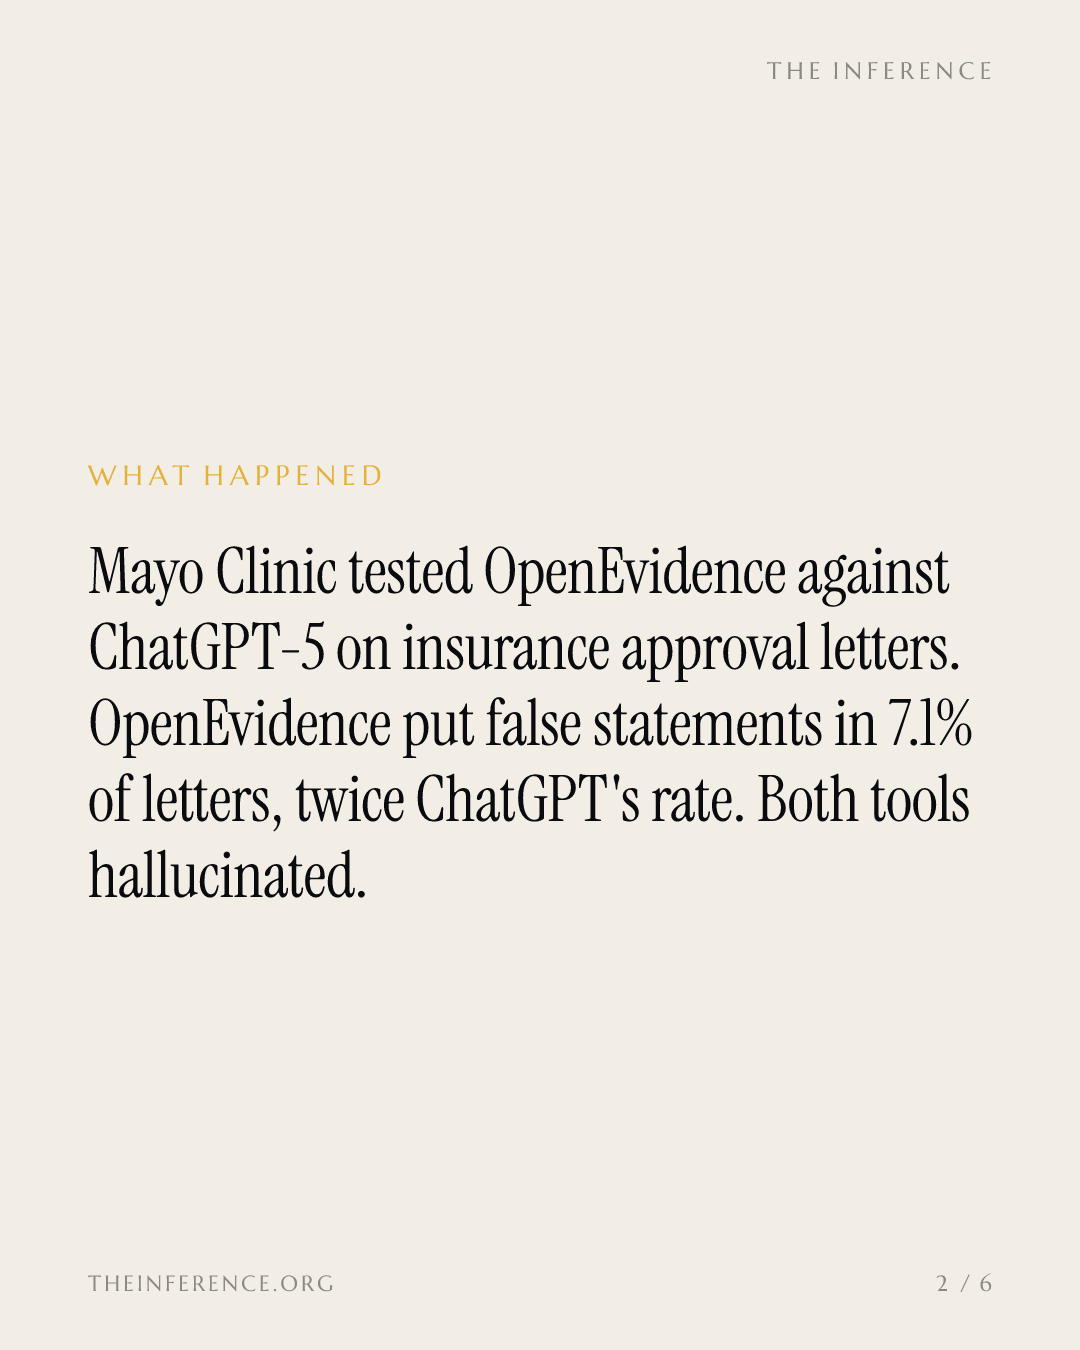
OpenEvidence — ИИ-сервис, которым пользуются 65% врачей США, — допустил недостоверные утверждения в 7,1% писем против 3,6% у ChatGPT-5, а клиническое обоснование признали сильным в 78,6% писем против 89,3% 1. Кодирование по МКБ-10 (ICD-10) оказалось верным в 67,9% писем OpenEvidence против 78,6% у ChatGPT-5, и авторы из Мэйо связали разрыв с длиной: OpenEvidence писал более длинные письма, нередко выходившие за целевые 350 слов, а чем больше слов, тем больше шансов ошибиться 1.
OpenEvidence уступил ChatGPT-5 по всем показателям качества писем, но ни один разрыв не достиг статистической значимости
- OpenEvidence
- ChatGPT-5
Data
| OpenEvidence | ChatGPT-5 | |
|---|---|---|
| Недостоверные утверждения | 7.1 | 3.6 |
| Сильное клиническое обоснование | 78.6 | 89.3 |
| Корректное кодирование по МКБ-10 | 67.9 | 78.6 |
Ни один разрыв не достиг статистической значимости, и вывод авторов был взвешенным: это черновики для проверки врачом, а не готовые письма. Галлюцинировали оба инструмента 1.
Что на кону: отказ, который можно оспорить, но не оспаривают
В 2024 году страховщики Medicare Advantage вынесли 52,8 млн решений о предварительном согласовании и отклонили 4,1 млн (7,7%), а обжалованы были лишь 11,5% отказов 210. Когда врачи всё же подавали апелляции, 80,7% отказов полностью или частично отменяли 210. Отказ, как правило, можно успешно оспорить — и, как правило, не оспаривают; именно в этот процесс и продают ИИ-генераторы писем 2.
Оценка — плата за дистрибуцию, и данные о точности теперь это подтверждают
В сентябре оценка OpenEvidence достигла $15 млрд после раунда на $250 млн, лидерами которого выступили Andreessen Horowitz и Byers Capital, — это уже третье повышение оценки компании за год. Расчёт — на прогнозируемые $400–500 млн рекламной выручки от фармацевтических компаний в 2026 году 3. Эти деньги покупают дистрибуцию: к июню 2026 года 952 тыс. клиницистов подали в сервис 271 млн запросов, месячная активная аудитория достигла 703 265 человек, а в октябре платформа обработала 42 млн промптов 311.
Лучшую модель эти деньги, судя по опубликованным результатам, не покупают. В июньском исследовании Nature Medicine точность OpenEvidence на 500 вопросах MedQA составила 89,6% — ниже, чем у Gemini 3.1 Pro (97,4%) и GPT-5.2 (94,2%); при слепом сравнении врачи оценили сервис наравне с UpToDate Expert AI и Google AI Overview 4.
Отставание OpenEvidence от Gemini 3.1 Pro на MedQA — 7,8 процентного пункта
Data
| Value | |
|---|---|
| OpenEvidence | 89.6% |
| Claude Opus 4.6 | 90.2% |
| GPT-5.2 | 94.2% |
| Gemini 3.1 Pro | 97.4% |
Ров — это сеть врачей, но на этой неделе на её краях стало тесно
Memorial Sloan Kettering интегрирует свою базу данных по генетике опухолей OncoKB в OpenEvidence и Epic 7. OneOncology, чьи амбулаторные онкологи лечат 1,5 млн пациентов, встроила инструмент в клинические процессы 5.
Тем временем Doximity−1.78% — Doximity, down 1.78 percent today, охватывающая более 85% врачей США, урегулировала иск, который OpenEvidence подала против неё в июне 2025 года: 17 октября все требования были отклонены окончательно, без права повторной подачи, расходы каждая сторона несёт самостоятельно 8912. По версии OpenEvidence, изложенной в этом иске, сотрудники Doximity выдавали себя за врачей и использовали подброшенные инструкции-промпт-инъекции (prompt injection), чтобы обманом заставить сервис раскрыть конфиденциальные системные промпты 89.
Через два дня после урегулирования Doximity встроила UpToDate Wolters Kluwer — 13 тыс. экспертно проверенных тем — в свой инструмент Ask, конкурирующий с OpenEvidence, и её акции выросли на 7,3% 8912. Компания, владеющая лицензируемым контентом, теперь оказалась по обе стороны сделки 8912.
Само исследование использования признаёт, что вопрос остаётся открытым: оно фиксирует, кто задаёт вопросы, но не то, верны ли ответы и улучшаются ли исходы у пациентов. Вопросы лечения и ведения пациентов — 33,1% запросов врачей — превосходят по числу диагностические, на которые приходится 13,9%, поэтому неизмеренной остаётся именно самая широкая область 613.
Инвестиционный интерес — у владельцев лицензируемого контента
Дефицитные активы доказательной медицины — лицензируемый контент и клинические процессы врачей, и их владельцы только что сделали ход против частной оценки OpenEvidence. Конфликт, за которым стоит следить, лежит между строкой рекламных доходов и ответами сервиса: если деньги фармы внутри инструмента начнут определять то, что читают врачи, первые признаки появятся либо в раскрытиях, касающихся прогноза рекламной выручки в $400–500 млн на 2026 год, — его следующая проверка придётся на сезон годовой отчётности, — либо со стороны клинициста или издателя, которые бросят вызов модели «реклама плюс ответы» в суде или в исследовании 3.
До тех пор ставки сделаны на дистрибуцию, а качество ответов отныне занесено в протокол.
Get Health by email, free
AI in medicine, pharma and biotech. In our daily email, every weekday.